拆開六個階段:security-audit-skill 從畫架構、切覆蓋單位到產出 findings.json,agent 到底照什麼順序做事
目錄
共 10 個章節
它到底是掃描器還是作業手冊?security-
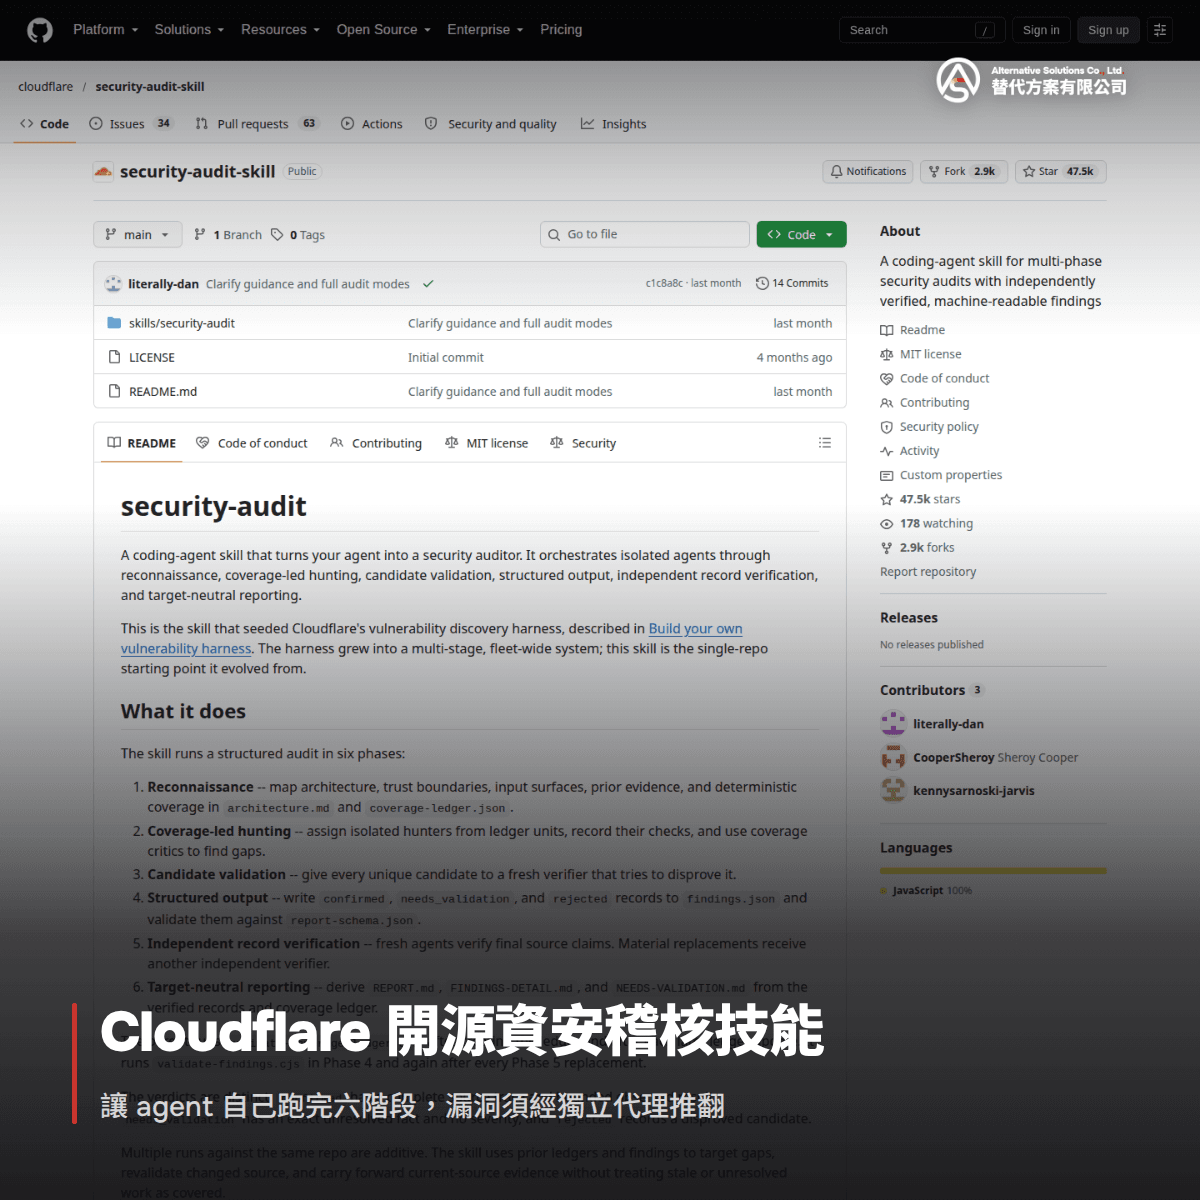
先講結論:它不是防毒軟體,也不是弱點掃描器。Cloudflare 開源的 security-audit-skill 是一份寫給 AI 助手(agent)看的資安稽核作業手冊;它的主體是十幾份 Markdown 文件,外加兩支零依賴的 Node.js 腳本。這兩支腳本只檢查輸出格式是否正確,不判斷你抓到的漏洞是否正確。換句話說,它像一本有標準流程的檢查表,把稽核拆成可執行步驟,而不是幫你掃描程式碼的黑盒子。
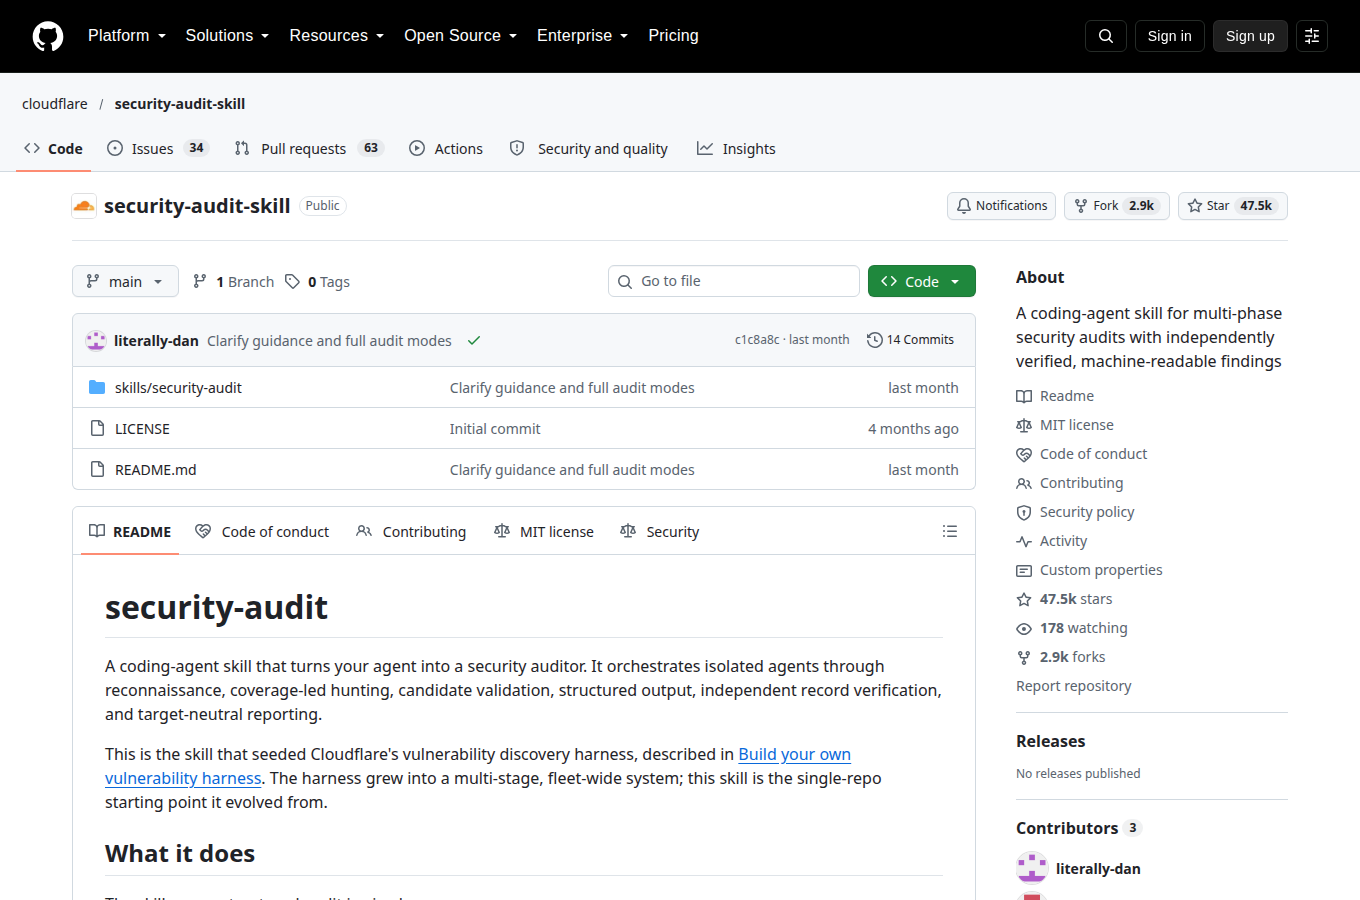
安裝只要一行指令,在終端機貼上 npx skills add https://github.com/cloudflare/security-audit-skill --skill security-audit,加上 --global 就裝在使用者層級。裝完後,在要被稽核的專案裡對 coding agent 說一句「security audit this codebase」,它就會照手冊跑完整流程。這裡的 coding agent 是指會開子代理、能跑指令的那種,不是單純聊天的版本。
六個階段與三種結論
依官方 README,流程拆成六個階段。第一階段的偵察先畫出系統架構、信任邊界與輸入介面,並產出 architecture.md 與 coverage-ledger.json。接著的覆蓋式搜尋會從清單切出獨立單位,派搜尋代理去查,再由覆蓋評論者找出遺漏的地方。第三階段的候選驗證是整套做法的核心,每個候選漏洞都交給一位沒參與搜尋的全新代理,任務是想辦法推翻它,推不翻才留下來。後面三個階段則負責結構化輸出、獨立重驗與報告產生。
相較於一般掃描器只告訴你「有問題」,這裡把結果分成三類。confirmed 是有完整來源追溯、真的跨過信任邊界的問題,needs_validation 是有一個明確未解的事實但不給嚴重度,rejected 則是被推翻的候選。這個設計讓報告不再只是「跟檢查表不一樣就打勾」。
跑完一次,電腦裡會多出什麼檔案?預設輸出資料夾是 ~/security-audit-skill/<repo-name>/run-<N>,每次執行一個編號,不會覆蓋前一次。打開會看到 architecture.md、findings.json、REPORT.md 等檔案。不過官方在 README 寫明單次執行不等於完整,把一次 run 當成結論是台灣團隊最常犯的錯。
六階段照順序拆:每一關交出哪個檔案、由誰負責做
上一章打開的那個輸出資料夾,是六個階段接力跑完的結果。Cloudflare 在 repo README 把順序訂成偵察、覆蓋式搜尋、候選驗證、結構化輸出、獨立紀錄驗證、目標中性報告,不能對調,前一關交出的檔案就是後一關的入場券。
第一關「偵察」由主代理自己扛,畫出系統架構、信任邊界與輸入介面,交出 architecture.md 和覆蓋清單 coverage-ledger.json。這份清單同時是第二關的工作分配表,建好要先跑格式檢查,欄位不齊就別往下走。
第二關「覆蓋式搜尋」把清單切成獨立單位,派搜尋代理分頭查,再請覆蓋評論者回頭找漏掉的地方。這關不定案任何漏洞,只留下「查過什麼、哪裡還沒查」,產出是更新後的覆蓋清單。
第三關才開始定案:每個候選漏洞交給全新的驗證代理,任務不是確認,是想辦法推翻,推不翻的才進第四關;第四關由主代理寫成 findings.json,分成 confirmed、needs_validation、rejected 三類,再交給驗證腳本檢查格式。
第五關「獨立紀錄驗證」再換一批沒參與過的新代理逐筆重驗;第六關才產出人看得懂的 REPORT.md、FINDINGS-DETAIL.md 與 NEEDS-VALIDATION.md。誰做事、交出什麼,看表最快:
| 階段 | 負責角色 | 交出的檔案 | 下一關拿到什麼 |
|---|---|---|---|
| 1 偵察 | 主代理 | architecture.md、覆蓋清單 |
系統邊界與待查單位 |
| 2 覆蓋式搜尋 | 搜尋代理+覆蓋評論者 | 更新後的覆蓋清單 | 查過與未查的範圍 |
| 3 候選驗證 | 全新驗證代理 | 推翻或保留的結論 | 通過對抗測試的候選 |
| 4 結構化輸出 | 主代理 | findings.json |
三類分好的清單 |
| 5 獨立紀錄驗證 | 另一批新代理 | 重驗後的紀錄 | 可信度打勾的結論 |
| 6 目標中性報告 | 主代理 | 三份報告文件 | 給人看的成品 |
對非工程師來說,流程最常卡在兩件事:第一關沒建覆蓋清單就直接開搜,以及驗證的人跟搜尋的人是同一組。盯住「清單有沒有建、驗證的是不是另一批代理」,品質大概就有底,也才看得懂報告裡哪些結論真的有證據。
對抗式驗證與兩道機械關卡:為什麼推不翻的候選才留得下來
「驗證的人不能跟搜尋的人同一批」不只是流程潔癖,而是整套做法最反直覺的地方。驗證代理的任務是想辦法推翻眼前的候選漏洞:推翻成功它就出局,用盡方法還是推不翻,它才有資格留下來。流程問的不是「這樣寫有沒有風險」,而是「有沒有辦法證明這個風險不存在」,因為前者容易自我催眠,後者才會逼人去找證據。
理由很現實:同一個代理剛讀完程式碼,心裡早有整組假設,要它回頭否定自己成本太高,於是傾向找理由支持原本的判斷。換成沒參與搜尋的新代理,沒有沉沒成本;官方還刻意讓發現與驗證使用不同模型,等於連思考習慣都換一組。
三類結論:把「不確定」留在檯面上
驗證結果強制分成三類,而不是「有問題」與「沒問題」兩種,因為不確定的事一旦被塞進二分法,就會變成沒人負責的黑洞。
| 結論 | 代表什麼 | 後續動作 |
|---|---|---|
confirmed |
有完整來源追溯,且有界觀察到實際結果 | 進正式報告,可當驗收附件 |
needs_validation |
有一個明確未解的事實,但不給嚴重度 | 另立文件,等人補齊環境 |
rejected |
已被驗證代理推翻 | 留紀錄但不進報告,避免重查 |
另一道防線是兩支機械關卡:之所以叫機械,是因為它們完全不判斷你判斷得對不對,只檢查格式與欄位有沒有缺。validate-coverage-ledger.cjs 管覆蓋清單,建成之後與每次更新都要跑一次;validate-findings.cjs 管發現清單,第四與第五階段每替換一次就跑一次。兩支都是零依賴的 Node.js 腳本,不必額外安裝套件。
這解決一個很現實的痛點:AI 產出的內容常常「看起來很完整」,但欄位少了、來源空了,人眼一筆一筆核對非常折磨;交給腳本之後,人就能專心看真正需要判斷的地方。但別指望它們幫你抓漏,欄位齊全但內容胡扯的報告,照樣會放行。
替代方案有限公司觀點:台灣團隊真正會卡住的不是提示詞,是沙箱與寫入隔離
很多團隊直覺是把提示詞抄一抄就能跑,實際下場是根本跑不動。手冊對「執行」的要求比對「思考」嚴格:原始碼檢視全程唯讀,任何要動到目標程式的建置、測試或模糊測試,都得關進作業系統層強制的沙箱。
沙箱就是一個跑壞了也波及不到別人的隔離房間,條件相當具體:
- 沒有對外網路,需要本機連線時只走隔離的 loopback。
- 空環境啟動,環境變數只從允許清單填入,HOME、暫存與快取都指向 scratch。
- 目標與工具鏈唯讀,被測程序只能寫自己的
scratch/,CPU、記憶體、程序數與執行時間都要明寫上限。
寫入隔離同樣硬:每個搜尋或驗證代理拿到獨立目錄,只能往自己的 scratch/ 寫;成品由父代理逐檔驗證後才搬進 artifacts/,過程檢查路徑、拒絕符號連結、確認型別與大小,還要避免競態。寫入權限沒切乾淨,稽核本身就會變成事故來源。
多數台灣中小企業的開發機或 CI 沒有這種環境,正確做法是誠實寫成 needs-validation 的阻礙,附上安全驗證計畫,標出這段沒驗。
我們建議的六階段落地順序
卡住的原因很少是模型不夠聰明,而是想一次到位。務實排法是先做第一階段偵察與第二階段覆蓋搜尋:只讀不寫、風險最低,卻能立刻產出架構圖與覆蓋清單,對沒有規格書的老系統特別有用。第三到第五階段涉及驗證代理與紀錄重驗,先在本機用容器切出獨立目錄、斷掉外網。第六階段報告直接當外包驗收或上線前附件,讓 confirmed 清單有名字、有來源。這套流程吃的是人看報告的時間,沒人讀,跑完只是多一個資料夾;先挑一個要交付的專案跑完一輪,再決定要不要擴大。
台灣場景的三個起點:外包驗收、老系統交接、上線前檢查
這套六階段流程對得上台灣中小企業三個時刻:外包驗收、老系統交接、上線前檢查。共同點是都缺一份說得清楚的紀錄。
第一是外包交付。過去驗收只看功能有沒有動、畫面有沒有跑版,資安靠合約一句「需符合資安規範」帶過。現在可請外包商在交付的程式庫跑一輪,把 confirmed 清單附在驗收文件後;每筆 confirmed 都要求來源追溯與實際觀察結果,不會丟一堆疑似清單要你自己判斷。
第二是老系統交接。沒寫過規格書的系統,原開發者離開後只能從程式碼裡猜。第一階段產出架構說明與覆蓋清單,強迫畫出系統邊界與輸入介面;交接拿到的不只是程式碼,還有「這套系統長什麼樣子」。
第三是上線前檢查。最常犯的錯是把測試金鑰或假資料一起提交進版本控制,每次都要靠人記得;寫進覆蓋清單就變成每次都得回答的固定題目。前提是專案在版控裡,沒進版控的東西它看不到。
期待要先分清楚
先分清它會做什麼、不會做什麼。
| 適合拿它做的事 | 不該期待它做的事 |
|---|---|
| 交付前的自我檢查,留下可追溯的清單 | 取代滲透測試或第三方稽核 |
| 為沒有規格書的系統補一份架構與覆蓋紀錄 | 保證零漏洞,跑一次就沒事 |
| 把金鑰與測試資料不進版控變成固定檢查項 | 在正式環境直接執行,或省下全部人力 |
它不是跑一次就結案。Cloudflare 自己的測試顯示,單次執行大約只找到重複執行總量的一半漏洞(專案 README 設計原則,2026-10-26 查閱),所以報告該寫「這次查到什麼、還有哪裡沒覆蓋」,不是「本系統安全」。
常見問題 FAQ
Q:這跟一般的漏洞掃描器有什麼不一樣?
它本身不是掃描器,而是給 coding agent 的一份作業手冊。流程拆成六個階段:先畫出系統架構與「確定性覆蓋」清單,再切出獨立單位派搜尋代理去查,每個候選漏洞都要交給一個「沒參與搜尋」的全新驗證代理,任務是想辦法推翻它,推不翻才留下來。結果分成 confirmed、needs_validation、rejected 三類寫進 findings.json,還有獨立代理重驗、產出報告。差別在於一般掃描器是照規則打勾,它要求每個結論都要有來源追溯、有實際跨過信任邊界才算數,縱深防禦少一層只算加固建議。
Q:跑一次就等於查完了嗎?
不夠,理由前面已經說明。它用「代理呼叫次數」當預算,一個覆蓋單位大約等於一次搜尋代理呼叫,一個候選漏洞約一到兩次驗證代理呼叫,而且規定要先保留評論者與驗證的額度再派搜尋,額度不夠就把執行標記為 incomplete,不准宣稱完整覆蓋。跑法有三種檔次:quick、standard、deep。沒有前次清單的話,報告裡也要說明。
Q:可以叫它直接對著正式站台跑嗎?
不行。技能規定原始碼檢視是唯讀的,要跑建置、測試、程序、瀏覽器或模糊測試,只能在作業系統層強制的沙箱裡,條件就是前一章列的那幾項。做不到這些控制就不能執行目標程式碼,要把「缺沙箱能力」寫成 needs-validation 的阻礙並給出安全驗證計畫。它另外明文禁止對正式站點或共用服務探測、對正式程序做可用性測試、發佈產出物、花付費 API 額度。實務上是在 repo 上跑,不是在正式環境跑。
📩 有任何問題或需要協助,歡迎聯絡我們:[email protected]
Related