性價比甜蜜點在哪?DeepSeek、GLM、Qwen、MiMo 這批中價與開源模型誰才是每月帳單的救星
目錄
共 12 個章節
同樣叫性價比,為什麼三家榜單給出三個不同的第一名
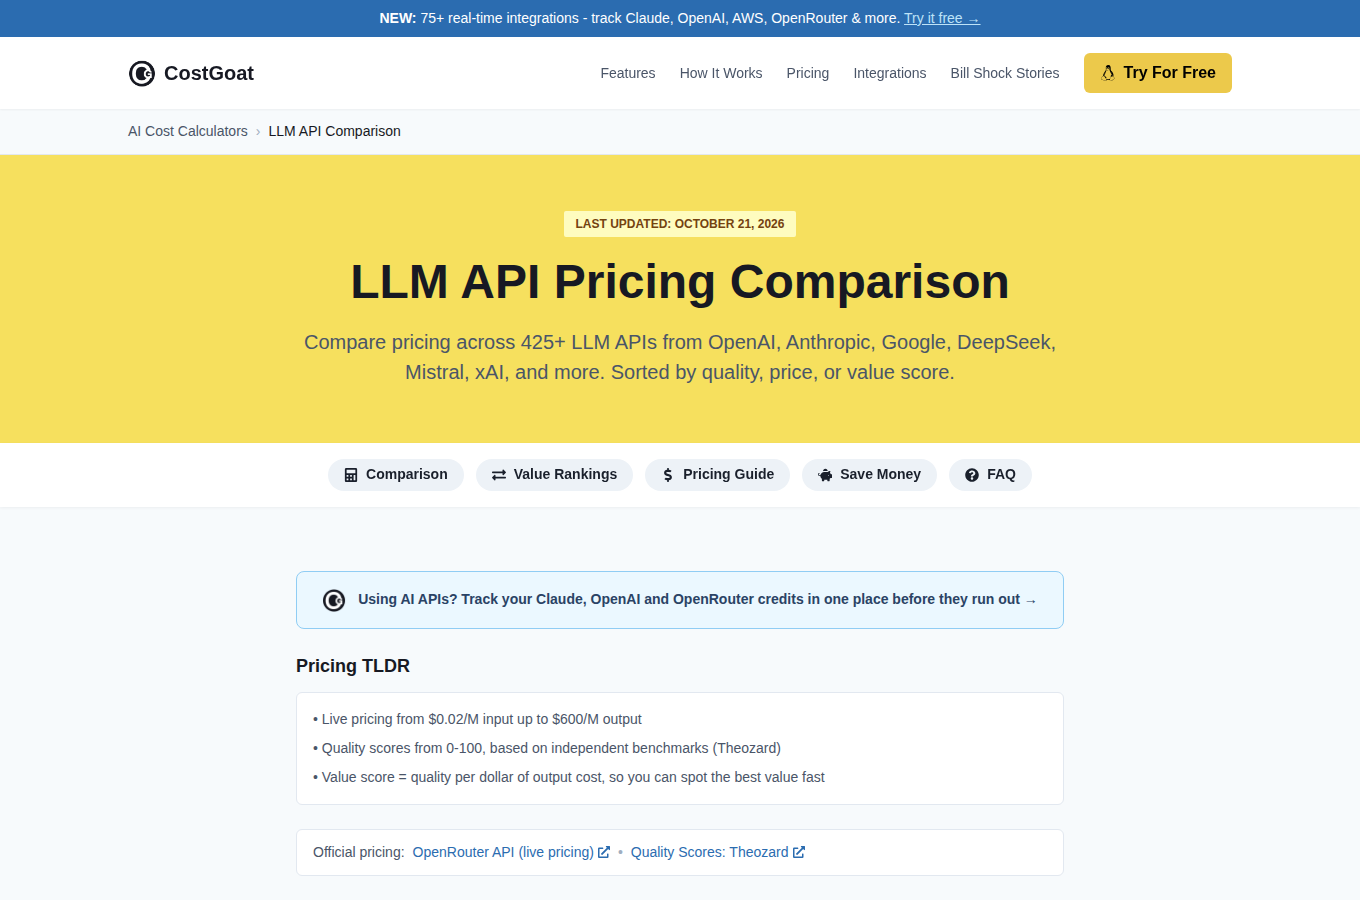
這個月打開 benchlm.ai 與 costgoat 的性價比排行榜,會看到三位不同的冠軍:Qwen3.7 Flash、DeepSeek V4.1 Flash,還有 Claude Sonnet 5.5。這兩個站都是國外整理 AI 模型分數與價格的比較網站,benchlm.ai 把各家測試分數換算成「每一美元能買到多少智能」,costgoat 先篩掉品質不到門檻的模型,再排出划算程度。三張榜單都沒有造假,問題出在「性價比」這三個字沒有統一算法,每家放進分子與分母的東西都不一樣。看排行榜,其實是在看別人怎麼定義「划算」。
分子放分數、分母放價錢,兩邊都有人換
先看 benchlm.ai 的第一組算法,它最直白,把分數除以每百萬 token 的輸出價,算出一塊美元能買到多少智能。Qwen3.7 Flash 以 46.93 分、每百萬輸出 0.13 美元,換算下來每一美元買到約 361 分,直接衝上第一。這套算法對便宜的小模型特別有利,分母壓得低,分數不難看就能衝高。
costgoat(2026 年 10 月更新)換掉的前提剛好相反,它先設一道品質門檻,只讓「真的能用」的模型進榜,再拿品質分除以輸出價。冠軍因此換成 DeepSeek V4.1 Flash,品質分 68、輸出價 0.14 美元,價值分數約 472。差別在它先把分數很高、價格也高的模型刷掉,傳達的訊息是「夠用就好,別為邊際分數多付錢」。
benchlm 還有第三組算法,先鎖定「至少保留領先者九成分數」的模型,再從裡面挑最便宜的。這一挑,Claude Sonnet 5.5 以 82.2 分、輸出價每百萬 10 美元勝出。它講的是另一種價值觀:我不要將就,只要比頂標便宜一點就好。
| 榜單(2026 年 10 月) | 分子 | 分母 | 冠軍 | 關鍵數字 |
|---|---|---|---|---|
| benchlm 第一組 | 智能分數 | 輸出價 | Qwen3.7 Flash | 每美元約 361 分 |
| costgoat | 品質分(先設門檻) | 輸出價 | DeepSeek V4.1 Flash | 價值分數約 472 |
| benchlm 第三組 | 九成頂標的最低價 | 輸出價 | Claude Sonnet 5.5 | 82.2 分、每百萬 10 美元 |
旗艦級也一樣。GPT-6 Astra 品質分 91、輸出價 50 美元,GPT-6.1 Sol 品質分 90、輸出價 10 美元,品質差不到百分之三,價錢差五倍。分母一換,你心中的第一名就會換人。
看榜單的順序要反過來。先問自己的工作負載是輸入為主還是輸出為主,再問能接受的分數下限在哪,然後才去挑算法最接近這個條件的榜單。把別人的第一名直接當成自己的答案,很容易買到一個分數漂亮、帳單也漂亮的模型。
DeepSeek、GLM、Qwen、MiMo 四家逐個看:便宜到什麼程度、強到什麼程度
把四家放在一起看,會發現它們不在同一個價位帶。截至 2026 年 10 月,每百萬個 token 的輸出牌價,DeepSeek V4.1 Flash 的 1017 版是 0.6 美元,小米 MiMo-V2.6-Flash 是 0.28 美元,智譜 GLM 5.3 Flash 是 0.2 美元,阿里 Qwen3.7 Flash 是 0.13 美元。對照 Claude Opus 5.5 的 20 美元,這四家用三十分之一到百分之一的價錢,賣出同樣的輸出量。
這裡有個容易搞混的地方:costgoat 榜上的 DeepSeek V4.1 Flash 標 0.14 美元,這裡的 0.6 美元卻是 1017 版的牌價,相差四倍。同一個名字不等於同一份價目表。以上都是牌價而不是帳單,實際付多少,還要看你的工作裡輸入與輸出的比例。
同一批模型,換個榜單就換個名次
同一個模型放進不同榜單,名次會劇烈變動,這是看排行榜最容易誤判的地方。小米 MiMo-V2.6-Flash 在 benchlm.ai 的算法下排第二,分數 64.51、輸出價 0.28 美元,分數比冠軍高出一大截,靠高分把比值拉了上來;同一個模型換到 costgoat 的榜上,卻退到第六名。
GLM 5.3 Flash 的處境剛好相反。它的品質分 73 比 costgoat 冠軍的 68 更高,卻因為只能拿到 0.18 美元的批次價而排在第三。分數多半來自 Artificial Analysis 智能指數(2026 年 9 月改版),這套量表怎麼算、改版爭議在哪,AI 模型的智能分數怎麼來的?Artificial Analysis 改版與品質分爭議,看懂排行榜背後的計算方式寫得更細。真正該記住的不是誰第一,而是每張榜單用什麼當分母、又把哪些模型擋在門外。
便宜之後,哪裡會掉分
這些分數是短題目測出來的,搬進日常工作會縮水。低價模型體型小,遇到要寫完兩三千字的報告,或連續十幾輪來回修改,中途忘記前面交代過什麼、輸出格式跑掉的情況明顯變多。輸出單價便宜,重試次數卻跟著增加,帳單未必真的省下來。
比較穩的做法是分層:長輸出與多輪對話交給單價高一點但穩定的模型,分類、抽取、改寫這類一次到位的工作交給這四家。四家各開一個小額帳號,用自己每週真實的十個任務跑一輪,看誰在你的資料上失誤最少,那才是你的第一名。
標價不等於帳單:用自家的輸入輸出比例算出真實單價
廠商網頁上的每百萬 token 價格其實是兩個數字:輸入價與輸出價。帳單長什麼樣子,取決於你送進去的字多、還是收回來的字多。很多人比價只看輸入那一欄,上線後才發現費用對不上。
算法很簡單,混合單價等於輸入佔比乘上輸入價,加上輸出佔比乘上輸出價。三種常見負載是輸入八輸出二、五五對分、輸入二輸出八;以下都用每百萬 token、美元計價,價格截至 2026 年 10 月(modelgrep 定價整理、Spheron 公開資料)。
DeepSeek V4-Flash 是四個例子裡最不受形狀影響的。輸入八輸出二的負載是 0.17 美元,五五對分是 0.21 美元,倒過來輸入二輸出八是 0.25 美元,三種情況只差 0.08 美元,代表它的輸入價與輸出價本來就接近,怎麼用都差不多。
其餘三個模型就不是這樣了。Grok 4.3 的三個數字是 1.50、1.88、2.25 美元,GPT-5.4-mini 是 1.50、2.63、3.75 美元,Claude Sonnet 5.5 則是 3.60、6.00、8.40 美元。同一個模型,負載從輸入為主倒向輸出為主,帳單最多可以多出一倍半,中間沒有任何一個欄位寫著「漲價」。
上面那串數字換個角度看更有意思。Grok 4.3 與 GPT-5.4-mini 在輸入為主的負載上都是 1.50 美元,看起來打成平手,倒向輸出後卻是一個 2.25、一個 3.75。差距來自輸出價是輸入價的幾倍:Grok 4.3 約兩倍,GPT-5.4-mini 約六倍,倍數愈大,愈偏輸出的用途帳單就愈痛。
折扣多半只砍在輸入端
批次與快取是常見的省錢手段,方向要看清楚。快取優惠幾乎都落在輸入價,Anthropic 的命中價降到原本的 0.1 倍,Google 的上下文快取可省八到九成(2026 年 10 月公開說明);輸出端通常只有批次五折可用。客服問答、會議摘要這類輸出佔比高的用途,快取設得再好,省下的金額也有限。
所以順序要反過來:先從自家日誌撈出一週的實際輸入輸出比例,再拿它算候選模型的混合單價。用別人的負載形狀挑模型,等於用別人的帳單替自己做決定。
替代方案有限公司觀點:省錢的關鍵是把任務分級,不是找一個最便宜的模型
我們協助台灣中小企業調整模型組合時,最常看到同一個旗艦模型扛下所有工作。原因很單純,公司只有一組金鑰,誰有需求就丟進去,沒有人去分這是客服回覆還是年報整理。這種用法在帳單出來前不會痛,一旦某個部門開始大量使用,費用就會突然跳一級,然後大家急著找最便宜的模型,卻沒回頭看是不是把所有任務都送到了最貴的地方。
四類工作,該掛在不同價位
依我們的經驗,企業內部的 AI 工作可以粗分成四種。客服回覆與文件整理量大、判斷需求低,答案有固定格式可循,用入門或中價位模型就夠,例如每百萬輸出 token 不到 1 美元的 DeepSeek V4-Flash(截至 2026 年 10 月定價)。程式協作與報表生成錯一次就要重工,值得用中高價位,這裡省下的不是 token 錢,是重工的時間。前面那組旗艦對照就是這種算法的結果:分數差不到百分之三,價差可以到五倍,多付的錢買的是失誤率,不是榜上的名次,完整比較見旗艦 AI 模型性價比真相:GPT-6 Astra 輸出每百萬 50 美元,GPT-6.1 Sol 只要 10 美元的品質對比。
順序上,我們建議先調用量的形狀,再換模型。形狀指的是輸入與輸出的比例、提示詞長度,以及有沒有重複的前綴可以快取。把固定的公司背景說明放進系統提示並開啟快取,省下的錢往往比換一個便宜三成的模型還多,而且不會動到回答品質。等帳單結構清楚了,再判斷哪一類任務可以下移到更便宜的層級,風險小得多。
分級不是免費的。多一層分流就多一份維護,出問題時要先判斷是模型挑錯還是提示寫壞,對沒有工程師的公司確實是負擔。我們的做法是只挑一到兩類高頻任務先試,用一週的實際日誌算出比例,再決定要不要擴大。台灣多數中小企業的用量還沒大到需要自己架機器,現階段把任務分級、把快取打開,就是最實際的省錢動作。
這張表三個月就會過期:台灣團隊自己更新價格的做法
2026 年 9 月 22 日,OpenAI 把 GPT-6 Sol 與 Luna 的輸出價格砍半,原本參考 Claude Opus 5.5 與 DeepSeek V4.1 Flash 的採購結論,一夕之間要重算。這件事說明重點不是哪家便宜,而是任何寫死在文章裡的價格表,保存期限大概只有一季。與其記住數字,不如建立一套每季十五分鐘就能跑完的查核流程。
三個動作,每季跑一次
第一件事是確認分數用的是哪一版量表。Artificial Analysis 在 2026 年 9 月 7 日改版到 v4.3,把 Terminal-Bench 從 2.1 換成 4.0,改版後全體分數一起下降,照舊文章的數字去比,會誤判成模型變差,其實是尺換了。查榜時先看頁面標注的版本號,沒標版本的一律當參考值。
第二件事是核對價格來源的更新日期。同一個模型在不同網站可能差上一截,常見原因是其中一邊還是舊價。我們習慣看兩個來源:modelgrep 的價格頁(2026 年 10 月版)與 CostGoat 的 API 比較表(2026 年 10 月 18 日更新),兩邊對得上才寫進內部文件,對不上就先標區間。
第三件事最容易被跳過,卻是最準的:拿自家上個月的 token 用量重算混合費率。token 是模型計費的單位,混合費率的意思是輸入佔比乘輸入價,加上輸出佔比乘輸出價。多數帳務後台都能匯出這兩個數字,填進前面的混合費率公式,就會得到符合自己工作形狀的單價。標價反映的是別人的假設,混合費率才接近你家的帳單。
這套流程的價值在於把「別人說」換成「我家算」,任何新報價進來,一個下午就能判斷要不要跟著換。
常見問題 FAQ
Q:有人說 Qwen 最划算、有人說 DeepSeek,到底哪個才對?
兩個都對,差別在「性價比」怎麼算。benchlm 把分數除以輸出價,冠軍是阿里 Qwen3.7 Flash;costgoat 只納入品質門檻以上的模型,算出來是 DeepSeek V4.1 Flash;benchlm 另一組算法找「保留領先者九成分數的最低價」,答案又變成 Claude Sonnet 5.5。分母換一個,結果就不一樣,所以先看自己的用量是輸入為主還是輸出為主,再挑對應的榜單,不要只看第一名就下單。
Q:便宜的開源模型品質真的能用嗎?跟旗艦差多少?
差距比想像小,但要看任務。旗艦與次旗艦的品質分常常只差不到百分之三,輸出價卻可以差到五倍。中價與開源這邊,GLM 5.3 Flash 品質 73、批次輸出約 0.18 美元;小米 MiMo-V2.6-Flash 分數 64.51、輸出 0.28 美元,在性價比榜上排第二。寫信件、整理文件、客服回覆這類任務用這一級就夠;最難的推理再往上叫旗艦。
Q:廠商說批次和快取可以省九成,我的帳單真的會降嗎?
要看你怎麼用。批次是全部費率打五折,OpenAI、Anthropic、Google 都有;快取多半只優惠輸入端,Anthropic 命中時降到原本 0.1 倍,DeepSeek 快取命中每百萬 token 只要 0.0028 美元。輸出端通常只有批次可用,很多標榜省九成的說法其實只算輸入端。先算混合費率,再決定要不要用。
📩 有任何問題或需要協助,歡迎聯絡我們:[email protected]
Related