旗艦 AI 模型性價比真相:GPT-6 Astra 輸出每百萬 50 美元,GPT-6.1 Sol 只要 10 美元的品質對比
目錄
共 11 個章節
旗艦模型的價位帶:從每百萬 10 美元到 50 美元隔了什麼
這一級的價格不是慢慢爬,是用跳的。每百萬輸出 token 從 10 到 50 美元之間,幾乎找不到 15、25、35 這種中間選項,廠商把旗艦擺在三個平台,選錯同樣工作量,月底帳單差五倍。
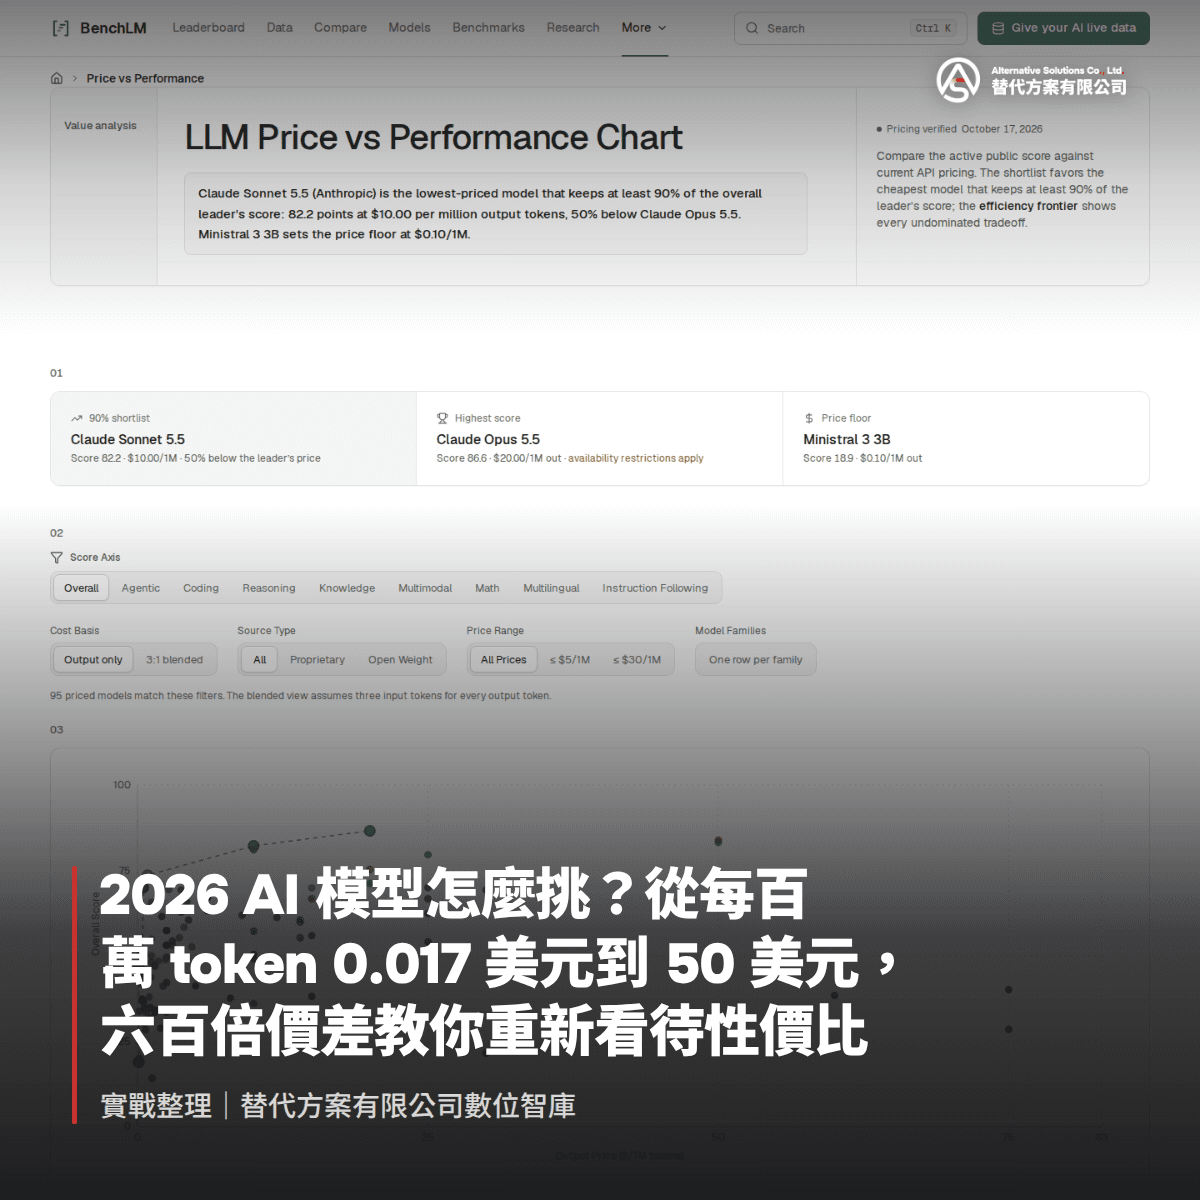
分層是按用量形狀設計:極長上下文或最難推理的任務推向 50 美元,一般商業應用擺在 20 到 30 美元,大量重複呼叫引導到 10 美元。市場最低的付費 API 每百萬輸入只要 0.017 美元,跟旗艦相差將近六百倍。
同樣冠上旗艦,價格卻分三層
最上層 GPT-6 Astra 與 Claude Fable 5.1,輸入 10 美元、輸出 50 美元;中間層 GPT-5.6 Sol 與 Claude Opus 5.5,輸出落在 20 到 30 美元;下層 GPT-6.1 Sol 與 Gemini 4 Argon,輸出只要 10 美元。
| 模型 | 每百萬輸入 | 每百萬輸出 | 品質分(來源) |
|---|---|---|---|
| GPT-6 Astra | 10 美元 | 50 美元 | 91(CostGoat) |
| Claude Fable 5.1 | 10 美元 | 50 美元 | 93(CostGoat) |
| GPT-5.6 Sol | 4 至 5 美元 | 20 至 30 美元 | 58.9(AA v4.3) |
| Claude Opus 5.5 | 4 美元 | 20 美元 | 57.6 至 58(AA v4.3) |
| GPT-6.1 Sol | 2 美元 | 10 美元 | 90(CostGoat) |
| Gemini 4 Argon | 2 美元 | 10 美元 | 未公布 |
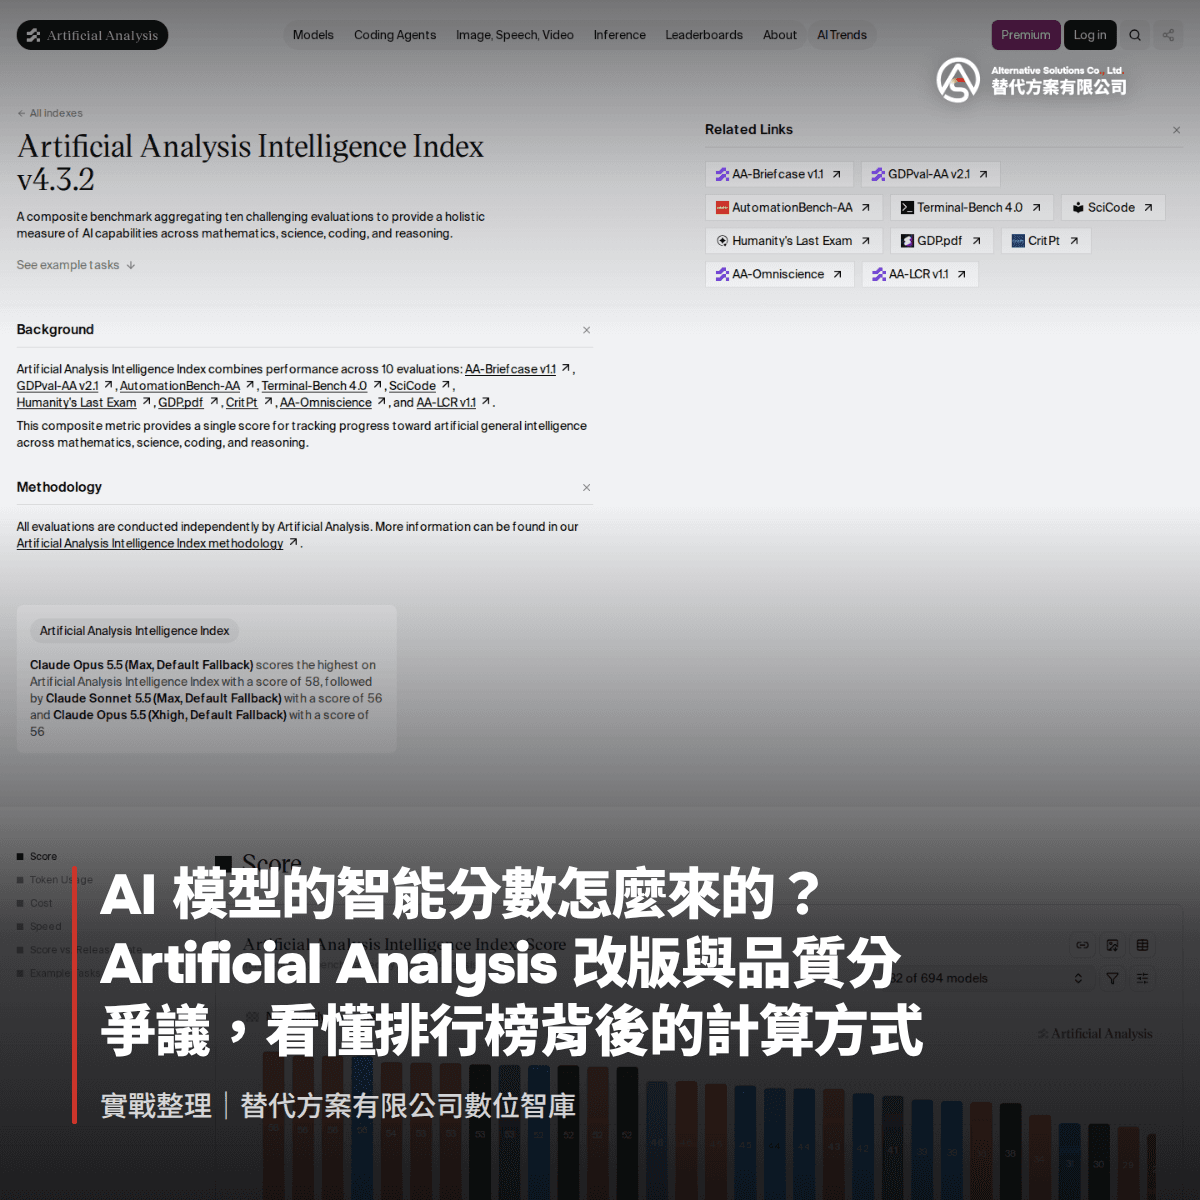
兩套品質分要分開讀。Artificial Analysis 的指數在 2026 年 9 月改版到 v4.3,全體分數下修,跟 CostGoat 不是同一把尺,不能拿 58.9 去對 90。
輸出價約是輸入價的 2 到 6 倍,Astra 與 Opus 5.5 都落在 5 倍。寫長文、產程式碼、生成報表這類輸出佔比高的工作,帳單會被輸出價主導;只拿模型讀文件做分類,痛感就沒那麼明顯。
廠商標的是兩條價格,你付的卻是一條混合價:把輸入佔比乘上輸入價,加上輸出佔比乘上輸出價,才是每百萬 token 的真實成本。以 Claude Opus 5.5 為例,工作偏讀文件(輸入佔八成)時每百萬只要 7.2 美元,一旦改成偏產出(輸出佔八成),同一個模型就跳到 16.8 美元,差了兩倍多。這也是為什麼直接拿廠商標價比大小沒有意義,先量出自己一個月的輸入輸出比例,比的才是自己的帳單,不是別人的。
折扣幾乎都只發生在輸入端:OpenAI 的 Batch API 全費率五折,Anthropic 快取命中時輸入價降到 0.1 倍,Google 上下文快取省八到九成,輸出端通常只有批次五折。批次與快取是輸入端的工具,換模型才是輸出端的工具。
最貴的未必最好。GPT-6.1 Sol 的輸出價只有 Astra 的五分之一,分數卻幾乎貼平,溢價值不值得要看工作型態。價格截至 2026 年 10 月,隨時可能被下一波降價改寫。
五倍價差的真相:品質 91 分與 90 分之間
上一節把價位分成三層,要問的是:多付的那 40 美元究竟買到什麼。攤開這幾款旗艦的品質分,其實貼得很近,最高與最低換算成百分比還不到百分之三,輸出價卻整整差五倍。這種局面光看排行榜很容易做錯決定,得先把分數的來歷拆開來看。
要判斷這筆溢價划不划算,得先看懂分數的來歷。這裡的品質分出自比價網站 CostGoat 的模型對照表(截至 2026 年 10 月),它把多項測試成績壓成一個整數,方便排名,同時也把細節磨掉了。分數接近,不代表能力的形狀一樣。
貴的五倍,買到的是規格不是光環
貴出來的那 40 美元,第一項買到的是罕見的長上下文。Astra 支援約 110 萬 token 的上下文視窗,等於一次能把數十份合約、整本程式碼或一整年的會議紀錄塞進去,不必先切片再拼回來。這種規格在短短幾句對話裡完全看不出價值,一旦工作變成「把整份文件讀完再回答」,差距立刻顯現。
第二項買的是長流程任務的穩定度。工具呼叫不失誤、指令遵循不打折、長篇產出不中途走鐘,這些特質不會直接變成排行榜上的分數,卻是最容易讓自動化流程卡住的地方。它們通常要跑過幾十次真實任務才感受得到,試用幾題是測不出來的。
還有一個容易誤判的地方:不同榜單的數字不能互相比。人工智慧分析指數(Artificial Analysis Intelligence Index)目前全體榜首 GPT-5.6 Sol 也才 58.9 分,跟品質分的 91 分擺在一起,會讓人誤以為模型退步,其實是兩把尺的刻度完全不同。看性價比時,分子與分母必須出自同一張表,否則算出來的倍率沒有意義。
什麼工作值得叫旗艦,什麼工作叫了就是浪費
選模型最常問錯的問題是「哪一個最強」,比較有用的問法是「這份工作配得上多貴的模型」。全部押在旗艦上,通常不是最省錢的花法。合理做法是把辦公室裡用到人工智慧的事情分成三類,分別給不同價位:
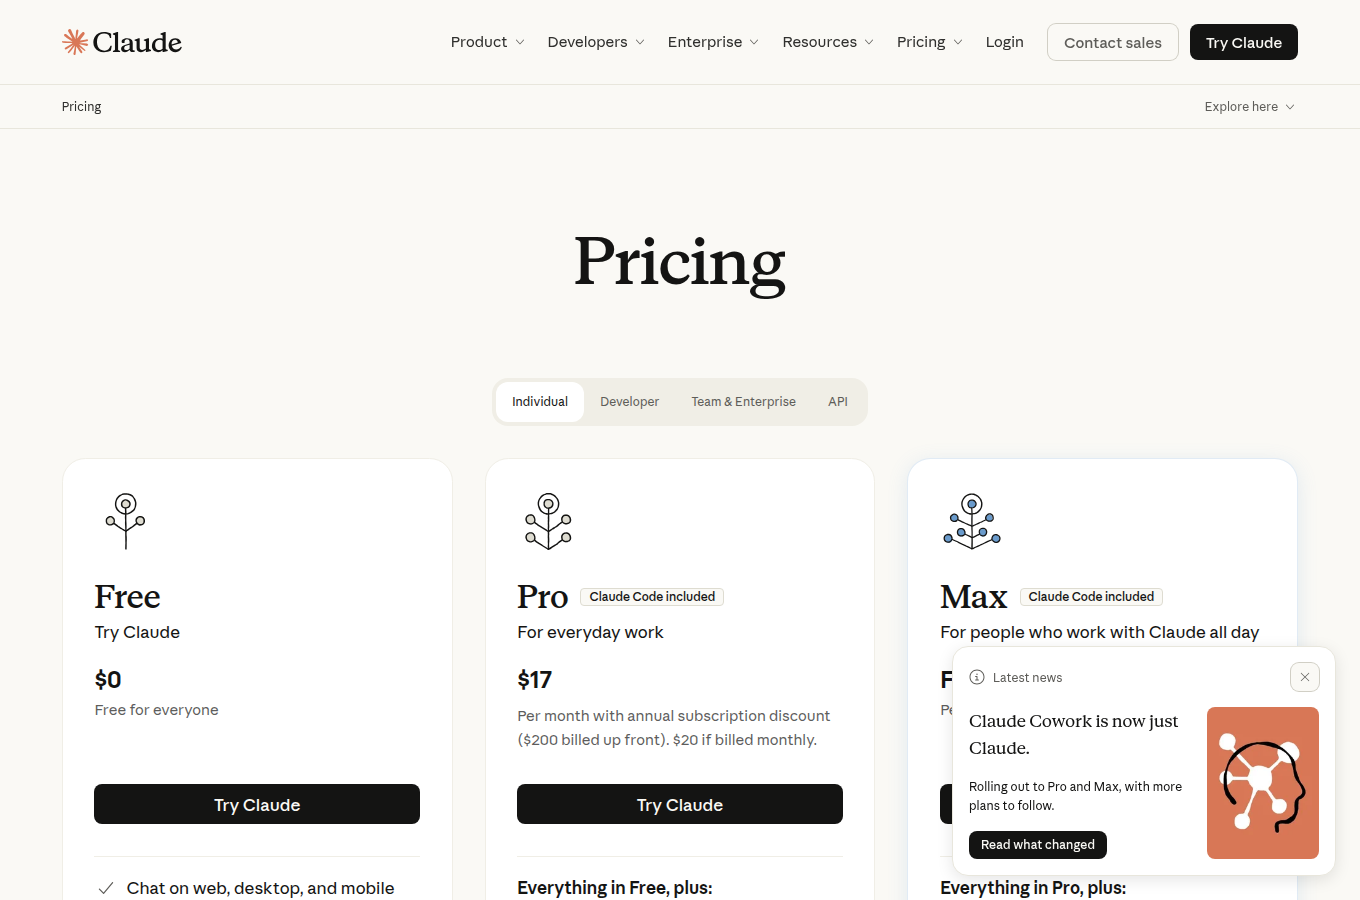
第一類值得叫旗艦,是需要長篇推理、來回改好幾輪的工作。寫一份送董事會的營運檢討、把散落的客戶抱怨歸納成改善建議、盯合約找出對我方不利的條款,這些任務錯一次就得整段重來,重做成本遠高於價差。截至 2026 年 10 月,對應的是每百萬輸出 20 到 50 美元那一級,例如 Claude Opus 5.5 的 20 美元、GPT-5.6 Sol 的 20 到 30 美元(modelgrep,2026 年 10 月)。
第二類也值得往旗艦靠,是需要吞下大量文件再統整的工作。把三十份報價整理成一張比較表,或讀完整年份的會議紀錄抓出反覆出現的問題,錢主要花在讀進去而不是寫出來。旗艦模型的輸入價約每百萬 2 到 10 美元,看起來不便宜,但同一批文件只要反覆問好幾次,快取能把重複讀取的費用壓到原本一成左右(Anthropic、Google 官方文件,2026 年)。
第三類叫旗艦來做就是浪費:大量重複的短問答。改寫一句客服回覆、把商品名稱轉成統一格式、判斷信件該歸到哪個資料夾,一次只處理幾十個字,對錯當場看得出來,重跑代價幾乎是零。這時用每百萬輸出 0.14 美元的 DeepSeek V4.1 Flash,或 0.5 美元的 Claude Haiku 5.5(benchlm,2026 年 10 月),跟旗艦差了幾十倍,效果卻差不多。硬派給旗艦,等於開貨車去買一杯咖啡。
分不出來時,看錯一次要付多少錢
不確定該歸哪一類,就問自己:這答案錯了要花多久補救。補救超過十分鐘、會影響客戶或金額的,往旗艦靠;只要改幾個字、重按一次按鈕的,就給入門模型。價差再大,也大不過人重做一次的時間。
替代方案有限公司觀點
我們最常被問哪個模型最強,但真正該問的是這件事值多少錢。同一個月,三家媒體的性價比第一名分別是 Qwen3.7 Flash、DeepSeek V4.1 Flash 與 Claude Sonnet 5.5,差別只在分母放的是輸出價、混合價,還是保留領先分數的門檻。
一條管線,一個價位上限
我們先做的不是選模型,而是把每月用量拆成幾條管線,各設價位上限與退場條件:單筆成本超過門檻就降一級,錯誤率連續幾天偏高就往上跳一級。客服回覆量大、單次短、答錯可重問,上限壓在每百萬輸出 token 十美元以下;文件摘要輸入特別長,挑輸入價低、上下文大的模型;報表產出講求格式穩定,寧可多花在輸出品質;程式輔助改壞邏輯的除錯時間往往超過省下的費用,上限反而拉高。
所以我們不建議把整間公司的用量押在最貴的那一級。原因不是旗艦不好,而是大部分日常工作用不到它多出來的那一點分數,把預算留給真正會出錯、出錯要重做的地方,整體比較划算。
有些工作要主動升級:答案錯了牽涉金額、法務文字或對外承諾,或同一個錯誤會讓同事停下來處理超過十分鐘,那條管線就不該留在最低價位。
報價單上的兩條價格要先混成自己的單價,才知道貴不貴。我們的做法是調出客戶系統一個月的實際 token 紀錄,算出輸入與輸出的比例,再回推真實成本。標價看起來接近的兩款模型,一旦按實際用量換算,差距往往比價目表上大得多。
批次 API 全部費率打五折,快取命中把輸入價壓到原本的十分之一,兩者都只優惠輸入端;輸出佔比高的管線,不如直接換輸出價更低的模型。2026 年 9 月 OpenAI 把兩個主力模型降價五成,我們每季重新比價。
用你的用量形狀算一次真實單價
廠商價目表寫的是兩個數字,輸入一個價、輸出一個價,但帳單只有一個總額。要算出真實單價,得把兩條價格依自己的工作比例混合:輸入佔比乘上輸入價,加上輸出佔比乘上輸出價。同一個模型,形狀不同,單價可以差兩倍以上。
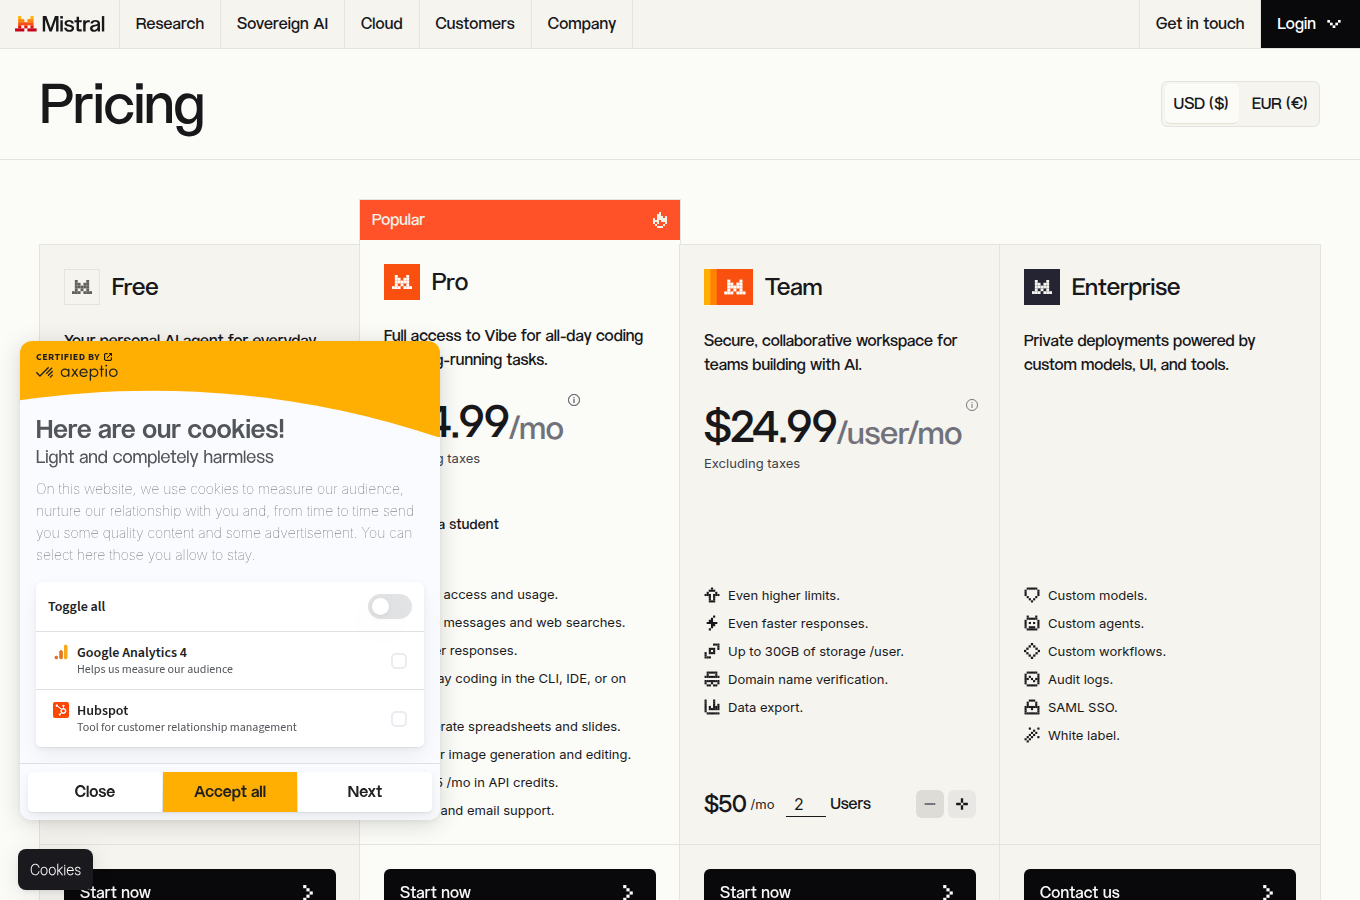
下面用三種常見負載試算:八成輸入的長文件閱讀、各半的客戶對話、八成輸出的寫程式。價格為 2026 年 10 月公開資料(modelgrep、CostGoat)。
| 模型(每百萬 token) | 輸入價 | 輸出價 | 輸入八成 | 各半 | 輸出八成 |
|---|---|---|---|---|---|
| GPT-6 Astra | $10 | $50 | $18 | $30 | $42 |
| Claude Fable 5.1 | $10 | $50 | $18 | $30 | $42 |
| Claude Opus 5.5 | $4 | $20 | $7.2 | $12 | $16.8 |
| GPT-6.1 Sol | $2 | $10 | $3.6 | $6 | $8.4 |
倍數沒變,痛感變了
GPT-6 Astra 與 GPT-6.1 Sol 在三個情境都維持五倍價差,因為兩者的輸出價都剛好是輸入價的五倍,形狀再換也動不了比值。改變的是金額:輸入為主時改用 Sol,每百萬 token 省 14.4 美元,輸出為主時省 33.6 美元。用量固定的公司,工作越偏輸出,選錯模型越痛。
價差會縮小,發生在兩個模型的輸入輸出比例不同時。2026 年 10 月的資料裡,Grok 4.3 與 GPT-5.4-mini 在輸入為主的情境都是每百萬 1.5 美元,打成平手;換成輸出佔八成,變成 2.25 對 3.75。原因是後者的輸出價是輸入價的六倍,前者只有兩倍。
折扣也綁在形狀上。快取與批次優惠多半只落在輸入端,輸入為主的帳單有機會壓到原價一成以下,模型之間的差距跟著被抹平;輸出為主的帳單只吃得到批次五折,選型的影響完整保留。
所以順序要倒過來。先撈出一個月的實際用量,算出輸入輸出比例,再拿它乘各家標價。我們輔導的台灣企業多半落在輸入七成以上,該做的不是換旗艦模型,而是把重複的長文件放進快取。
常見問題 FAQ
Q:比較貴的模型一定比較聰明嗎?
以 2026 年 10 月的資料來看,不一定。同一級距裡最貴與最便宜的兩款,分數差距換算成百分比不到百分之三,價錢卻差五倍,多付的部分買到的是長上下文與長流程的穩定度,不是壓倒性的聰明。真正該問的是你的工作會用掉多少輸出 token、答錯要不要整段重做,而不是哪個模型名字聽起來最強。
Q:廠商標的價格跟我實際收到的帳單,為什麼差這麼多?
因為公布的是每百萬 token 的單價,帳單卻是被你「輸入」和「輸出」的比例決定的。輸出價通常是輸入價的二到六倍,同一支模型用在讀文件跟用在寫文章,成本就會差很多。以 GPT-5.6 Sol 為例,輸入佔八成時每百萬大約 10 美元,輸出佔八成時會拉到 25 美元。GPT-5.4-mini 的輸出價是輸入價的六倍,Grok 4.3 只有兩倍,輸出量大的工作,兩者差距會比標價看起來更大。
Q:網路上的「性價比排行」為什麼每家第一名都不一樣?
因為這類排行背後的算式並不一樣。有的網站拿模型的分數直接除以輸出價,算的是「一分性能要花多少錢」;有的網站把輸入與輸出的費用先按比例混成一個數字再比;還有一種算法是先刪掉落後領先者超過一成的模型,再從剩下的人裡挑最便宜的。算式一換,冠軍就跟著換,同一個月裡就出現過 Qwen3.7 Flash、DeepSeek V4.1 Flash 與 Claude Sonnet 5.5 三個不同的第一名。所以看到性價比排行,先確認它算的是單純輸出價還是混合費率,再對照自己的實際用量,才不會選到一個對別人的情境很划算、對你卻不划算的模型。
📩 有任何問題或需要協助,歡迎聯絡我們:[email protected]
Related