台灣中小企業怎麼選 AI 模型?客服、文件、程式、報表四種場景的模型分派與預算配置
目錄
共 12 個章節
先看清楚:台灣中小企業的 AI 帳單,多半花在不需要那麼強的任務上
台灣中小企業導入 AI,帳單失控通常不是用量暴增,而是預算放錯位置。最常見三個錢坑:全公司共用同一個旗艦模型,連改錯字都動用最高階推理;只看廠商標價就下單,沒算過自己的工作負載;打開排行榜直接挑第一名。三件事聽起來都合理,但每一件都會讓成本多出好幾倍。
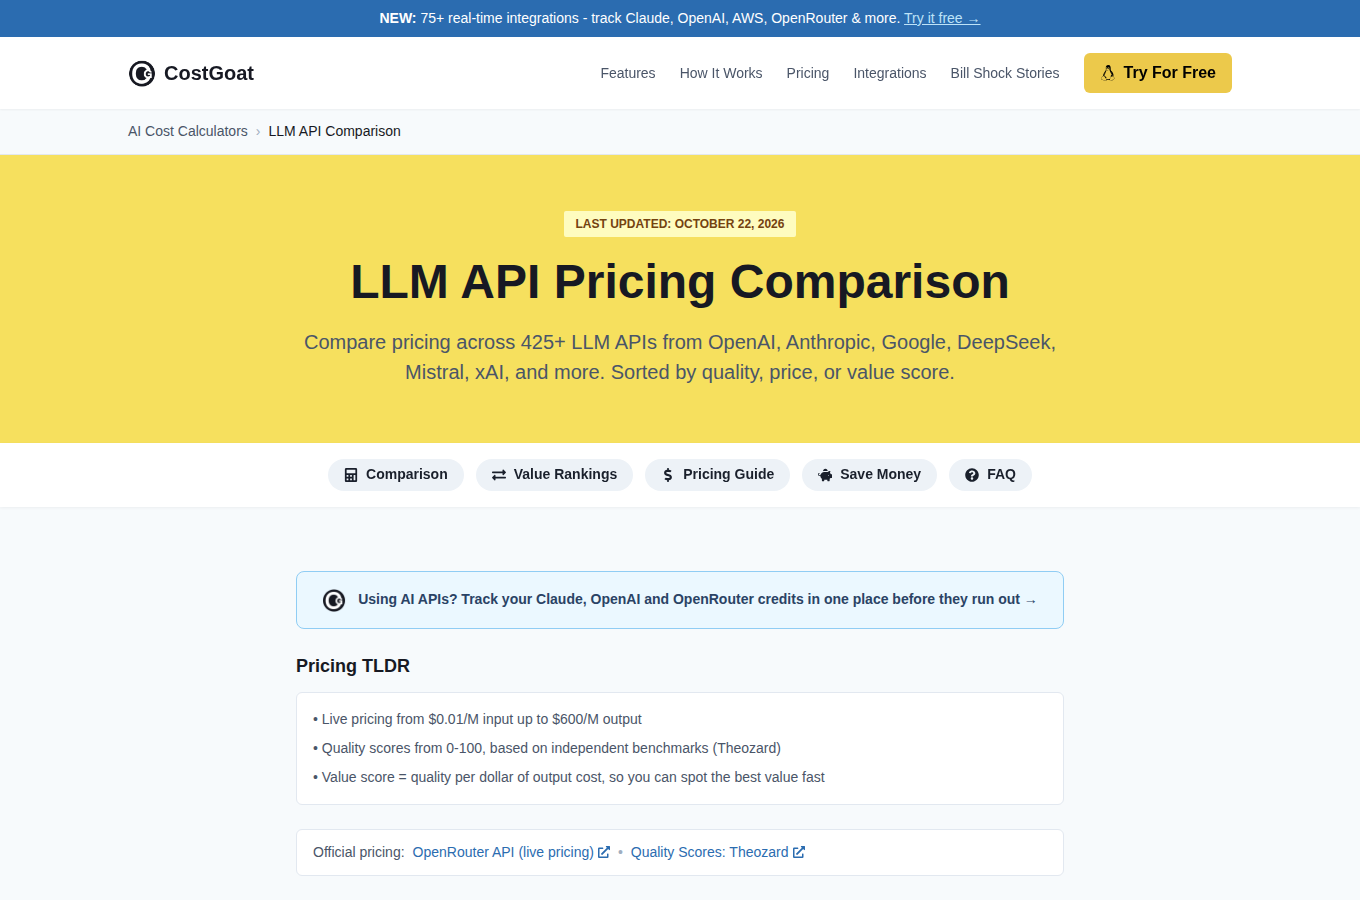
「性價比」這三個字沒有標準答案。2026 年 10 月同時去看三份公開的模型比較表,冠軍竟然不是同一個模型。這幾份表其實都在算同一件事,就是花多少錢能換到多少分數,只是分母放價格、分子放什麼各有各的選擇。benchlm.ai 拿單次評測分數除以輸出價,算出 Qwen3.7 Flash 最划算;costgoat 改用綜合品質分,結論換成 DeepSeek V4.1 Flash;benchlm 另一套算法把標準放寬成「有領先者九成分數就好,只比誰最便宜」,推的是 Claude Sonnet 5.5。三份榜單都沒有算錯,差別在它們衡量的東西不同,所以直接把第一名抄回家套用,通常拿不到你要的結果。
將近六百倍的價差是同樣道理。最便宜的付費 API 是 IBM Granite 4.0 Micro,每百萬輸入 token(模型計費的基本單位)僅 0.017 美元;最貴的 GPT-6 Astra 輸入 10 美元、輸出 50 美元。這條價差線我們在〈2026 AI 模型怎麼挑?從每百萬 token 0.017 美元到 50 美元,六百倍價差教你重新看待性價比〉裡完整算過,這裡只取結論:這不是廠商坑人,是兩種不同產品,旗艦賣複雜推理與超長上下文,入門賣穩定、快速、便宜。拿旗艦做分類標籤,像開卡車去買菜。
同一件工作,換模型帳單差多少
把場景縮小到中小企業每天在做的事:整理客服信件、把會議錄音轉成摘要。共同點是輸出短、判斷簡單。以每月輸出 1,000 萬個 token 試算,走 DeepSeek V4.1 Flash 每個月約 1.4 美元;換成 Claude Fable 5.1 要 500 美元,差三百多倍,品質卻幾乎看不出差別。
真正該做的不是找最便宜的模型,而是把工作拆開分派。摘要、分類、格式轉換交給入門或中階模型,需要判斷推理的環節才動用旗艦。每個月省下來的錢,往往比重新談合約還多。
標價不等於帳單:混合費率怎麼算,為什麼它才是預算的真正基準
任何一份模型價目表都有兩個數字:每百萬 token 的輸入價與輸出價。模型收到問題要先「讀」一次(輸入),再「寫」一次(輸出),輸出價通常是輸入價的 2 到 6 倍,所以真正決定你付多少錢的是這兩者的比例,不是官網上那行招牌價。
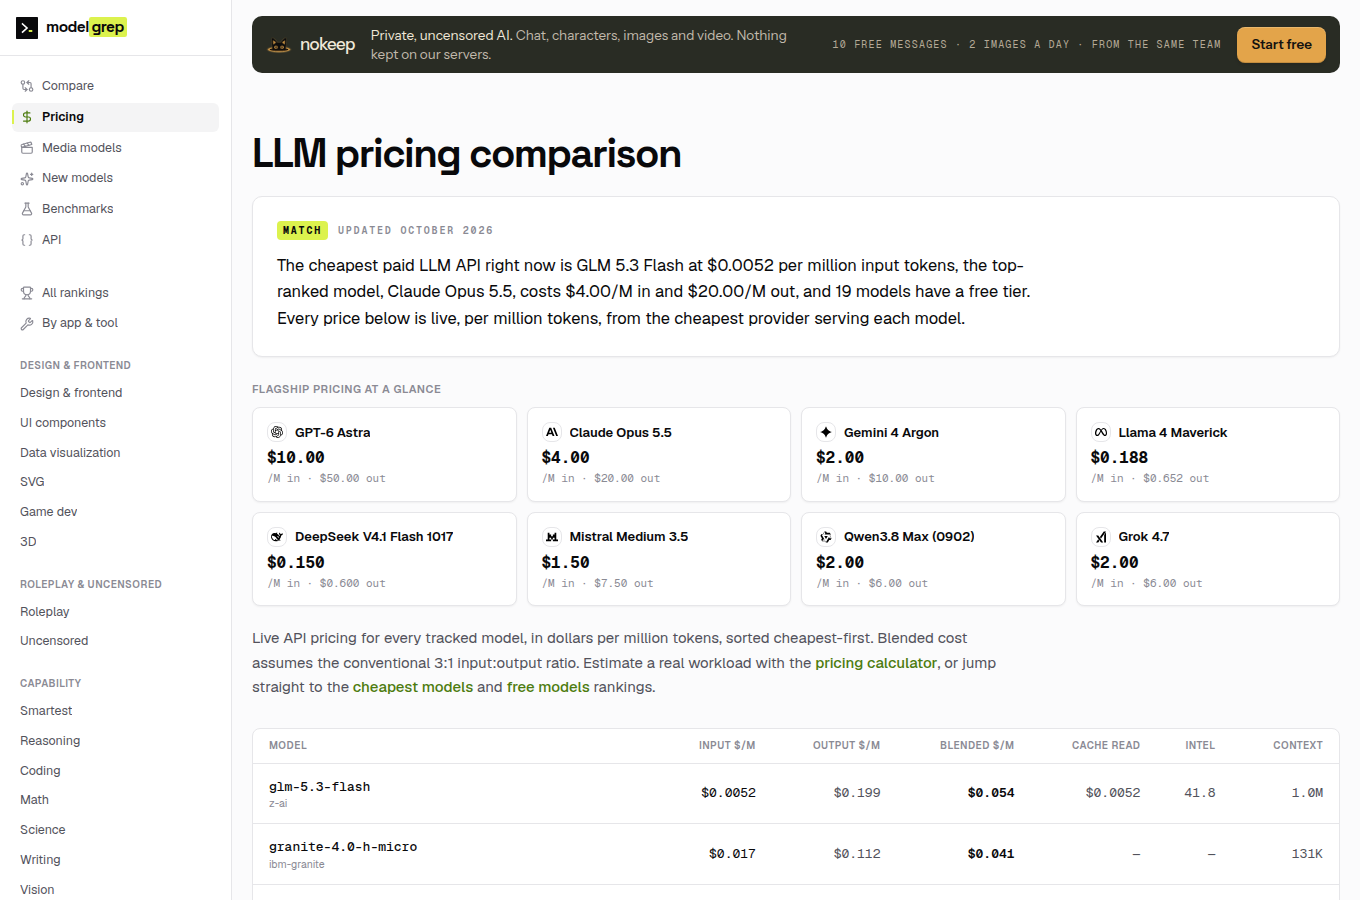
把比例算進去就是混合費率,白話說就是「這份工作平均每百萬 token 實際要付多少」,算法是輸入佔比乘輸入價,加上輸出佔比乘輸出價。以 Grok 4.3 和 GPT-5.4-mini 為例,在輸入八、輸出二的負載下兩者打平,每百萬 token 都是 1.5 美元;換成輸出吃重的工作,一個是 2.25 美元,另一個跳到 3.75 美元,差別在輸出價對輸入價的倍數,前者 2 倍、後者 6 倍。這組數字來自 modelgrep 的定價整理(2026 年 10 月)。
下表用三種負載比例換算,單位是美元/每百萬 token。
| 模型 | 輸入八、輸出二 | 五五 | 輸入二、輸出八 |
|---|---|---|---|
| DeepSeek V4-Flash | 0.17 | 0.21 | 0.25 |
| Claude Sonnet 5.5 | 3.60 | 6.00 | 8.40 |
| Claude Opus 5.5 | 7.20 | 12.00 | 16.80 |
先分清楚自己的工作是哪一種形狀
換了場景,排名就翻轉。客服自動回覆、會議錄音轉摘要這類任務每次都要產出完整段落,輸出量往往比輸入多;文件問答、法規檢索則相反,整份文件塞進去,模型只回一小段。台灣企業的日常工作通常混著這兩種,採購時要拿自家任務的長短比例去套。
快取與批次折扣只優惠輸入端
省錢機制幾乎都集中在輸入端。Anthropic 靠快取把命中的輸入價壓到原本的 0.1 倍,Google 的上下文快取能省八到九成,OpenAI 則用批次 API 把全部費率打五折。輸出端通常只剩批次五折這一個折扣,客服、寫稿這類輸出量大的任務根本享受不到。看到「省九成」的宣傳,先問它省的是輸入還是輸出,再用混合費率重算一次。
四種場景怎麼分派:客服、文件、程式、報表各該用哪一級模型
台灣企業導 AI 最常卡在同一個問題:所有任務都丟給同一個最強的模型,帳單撐不住;全部改用最便宜的小模型,錯誤率又高到要人工重看。實務上該先把日常工作分成兩類,一類量大、出錯還有人補,一類量少、錯一次就整段重來。前者壓單價,後者買保險。
客服與文件:量大,重點在壓低輸出單價
客服自動回覆、產品文件問答、法規條文檢索,共同點是輸入短、輸出長,而且同一批問題反覆出現。這類工作該做兩件事:先把快取打開,讓重複的提示只算一次錢;再把模型降到中價位。截至 2026 年 10 月,Claude Sonnet 5.5 每百萬輸出 token 收 10 美元,DeepSeek V4.1 Flash 只要 0.14 美元,相差七十倍,而有標準答案的客服,多數情境用不到頂級模型的推理力。想更保險,可以讓便宜模型先跑,遇到它自己標記不確定的問題再轉給貴的模型。
程式與報表則是反過來。寫一段資料庫查詢、產出一份月結報表,一個月可能只跑幾十次,但錯一個欄位就要重工半天,還要重新核對數字,省下的幾塊錢遠不如一次重跑的工時。這類任務建議直接上中高階模型。以 GPT-6.1 Sol 為例,每百萬輸出 10 美元,CostGoat 在 2026 年 10 月給的品質分是 90,跟最貴的 GPT-6 Astra(91 分、輸出 50 美元)只差一點,價格卻只有五分之一。
| 場景 | 特徵 | 建議等級 | 參考模型 |
|---|---|---|---|
| 客服 | 量大、輸出長、答案重複 | 中價位加開快取 | Claude Sonnet 5.5、DeepSeek V4.1 Flash |
| 文件問答 | 輸入長、輸出短 | 中價位、長上下文 | Gemini 3.1 Pro |
| 程式 | 次數少、錯一次要重工 | 中高階 | GPT-6.1 Sol |
| 報表 | 次數少、數字要準 | 中高階 | GPT-6.1 Sol |
分派不是一次定生死。每季把帳單拉出來,看哪一類任務花最多,再回頭調整等級,會比一開始就追求完美配置務實得多。
替代方案有限公司觀點:先分派任務再挑模型,是台灣企業最省錢的落地順序
我們輔導台灣中小企業導入 AI,與其問「哪個模型最強」(榜單每月換人),不如先問「哪類工作要交給 AI」。順序錯了,把內部公告潤稿送進最貴旗艦模型,等於用高鐵票價搭市區公車。
做法是先把內部任務盤成四類:客戶應答、文件問答、程式協作、報表整理。四類天天發生,差別在輸入與輸出比例。客服一問一答,兩邊都短但次數多;文件問答是丟進整份合約、只取一段答案,輸入長、輸出短。這比例決定帳單,輸出佔比高的任務,同一組模型算下來的單價就是比較貴。至於旗艦與中階模型的實際差距,我們在〈旗艦 AI 模型性價比真相:GPT-6 Astra 輸出每百萬 50 美元,GPT-6.1 Sol 只要 10 美元的品質對比〉裡有完整對照。
從單一模型走到多層配置的漸進做法
第一階段只用一個中價位模型,所有任務丟進去跑滿一個月,目的不是省錢,是拿到真實用量:哪類任務呼叫最多次、每次帶進多少字。有紀錄才能算混合費率,也就是把輸入與輸出比例套進價格後的實際單價。第二階段挑最花錢的那一類往下換便宜模型,先小範圍測試,答錯率可接受就留著。第三階段才把程式與報表往上換成中高階模型。
台灣企業最常犯的錯不是選錯模型,而是一開始就買最高階方案,用了三個月才發現八成呼叫都在問簡單問題。相反的,為省錢全壓到最便宜模型,客服語感不對、報表數字對不上,重工人事成本遠高於價差。配置原則是「一類任務一個等級」,四類任務最多用到三個等級,層級愈多維運與追蹤負擔愈重。至於自架機器,除非每月穩定用量明顯超過租用成本,否則維運人力往往吃掉省下的錢。
把帳單真的壓下來:批次、快取、模型串聯與自行架設的實際做法
帳單變貴時,多數人第一個念頭是換一個更便宜的模型,但真正決定金額的是工作負載的形狀。同一個模型跑摘要型任務(輸入多、輸出少)與寫稿型任務(輸入少、輸出多),單價可以差到一倍,所以前面算好的混合費率要一直擺在手邊當基準,下面四個手段才看得出哪一個對你有效。
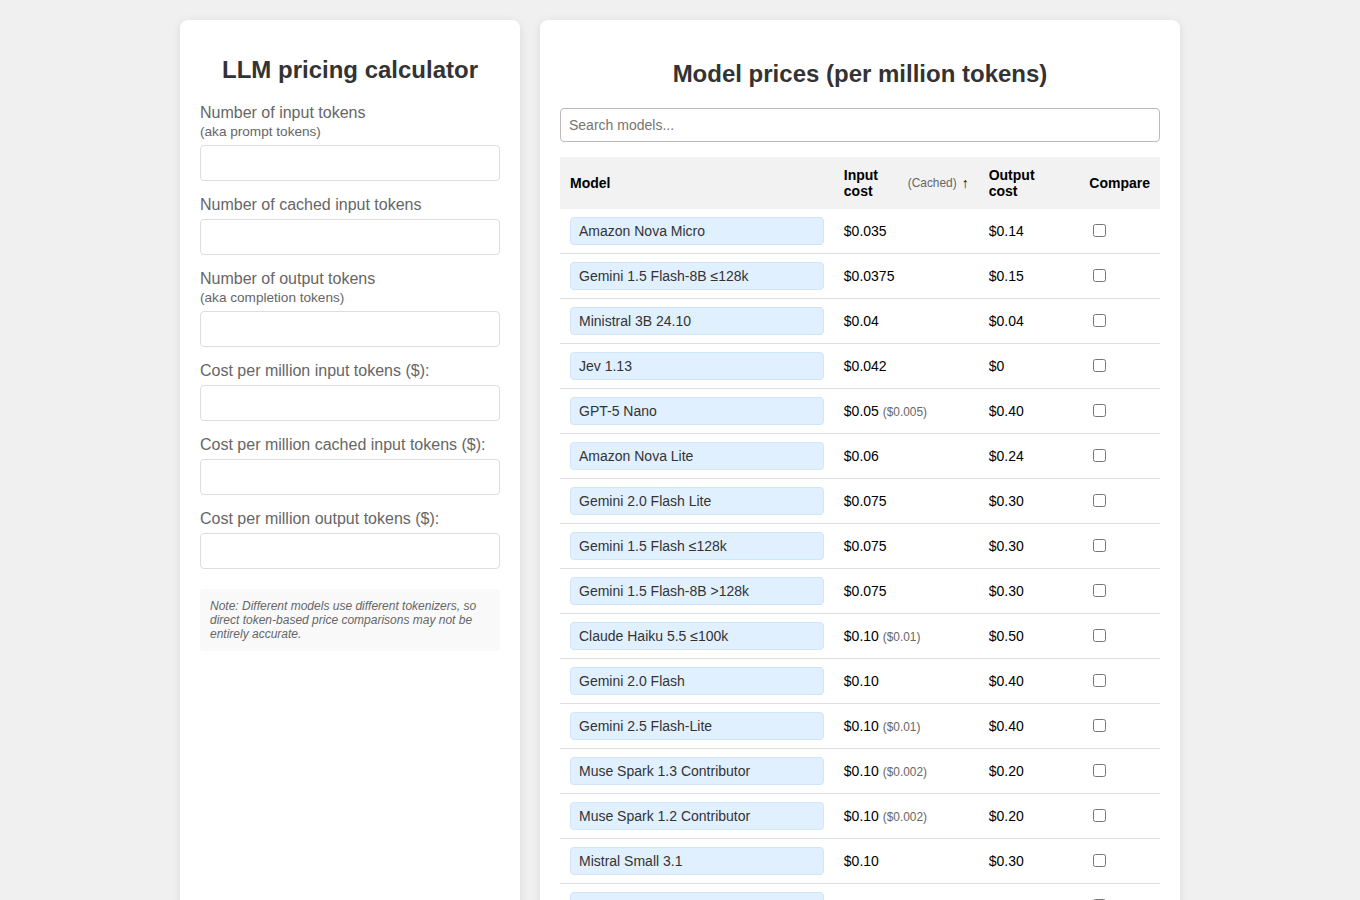
批次處理用在不必即時回覆的任務,例如每晚整理客服對話、固定產出月報。OpenAI、Google 與 Anthropic 的批次服務都是全部費率打五折,代價是要排隊,對即時對話沒有幫助,卻是最容易被忽略的一筆。
提示快取處理的是重複。同一段系統指令每次重送,就等於每次重付一次錢,而快取命中時,Anthropic 官方定價的輸入價降到原本的 0.1 倍,Google 的上下文快取可省八到九成,DeepSeek 的命中價每百萬 token 只要 0.0028 美元。要注意的是,批次與快取幾乎只優惠輸入端,輸出為主的任務享受不到,這也是很多「省九成」說法對不上帳單的原因。
模型串聯與自架的損益兩平點
串聯則是把工作拆開,讓便宜的模型先分類、抽欄位、寫草稿,再由強模型複核。只把真正需要判斷的一小段交給貴模型,而不是整份文件送進去,帳單自然跟著降。
自己租 GPU 適合用量穩定且量大的情境。以每小時 2.64 美元的 H100 租用價計算,每百萬 token 成本等於每小時叢集成本,除以每秒 token 數乘 3600 再除以一百萬。每秒產出 2000 token 時約 0.37 美元,掉到每秒 200 token 就變成 3.7 美元,比多數 API 還貴。所以自架不是一定比較省,而是吞吐夠高、跑得夠滿才划算。
常見問題 FAQ
Q:我們公司規模不大,有需要自己架 AI 模型嗎?
除非某個任務的用量已經又大又穩定,否則先別自己架。上面算過的損益兩平點會隨著你想取代哪一個 API、以及自架模型最小的可用叢集規模而變動,兩者差距可以到兩個數量級。對多數中小企業來說,先把工作分派給不同價位的模型,會比先買機器更早看到效果。
Q:客服、文件、程式、報表,是不是挑一個最強的模型全部丟給它就好?
不用。真正的問題不是選哪一個最強的模型,而是有沒有把不同任務分派給不同價位。最貴的也不見得最好,GPT-6 Astra 品質分 91、輸出每百萬 token 50 美元,GPT-6.1 Sol 品質分 90、輸出 10 美元,品質差不到百分之三,價錢差五倍。客服回覆這種量大、格式固定的工作,用便宜的就夠,需要推理的程式與報表分析再往上加,實際配法還是要拿自己的用量試算。
Q:廠商說快取能省九成,帳單真的會少那麼多嗎?
通常不會。批次與快取多半只優惠輸入端,輸出端一般只有批次五折。Anthropic 快取命中時輸入價降到原本的 0.1 倍,Batch API 另外打五折,兩者可以疊加,但如果你的工作以輸出為主,例如生成報告或長篇文件,省到的就有限。輸出價通常是輸入價的二到六倍,所以真正的帳單要看輸入與輸出的比例,也就是混合費率,先弄清自己的負載是八比二還是二比八,再回頭看那些折扣數字。
📩 有任何問題或需要協助,歡迎聯絡我們:[email protected]
Related