AI 模型的智能分數怎麼來的?Artificial Analysis 改版與品質分爭議,看懂排行榜背後的計算方式
目錄
共 11 個章節
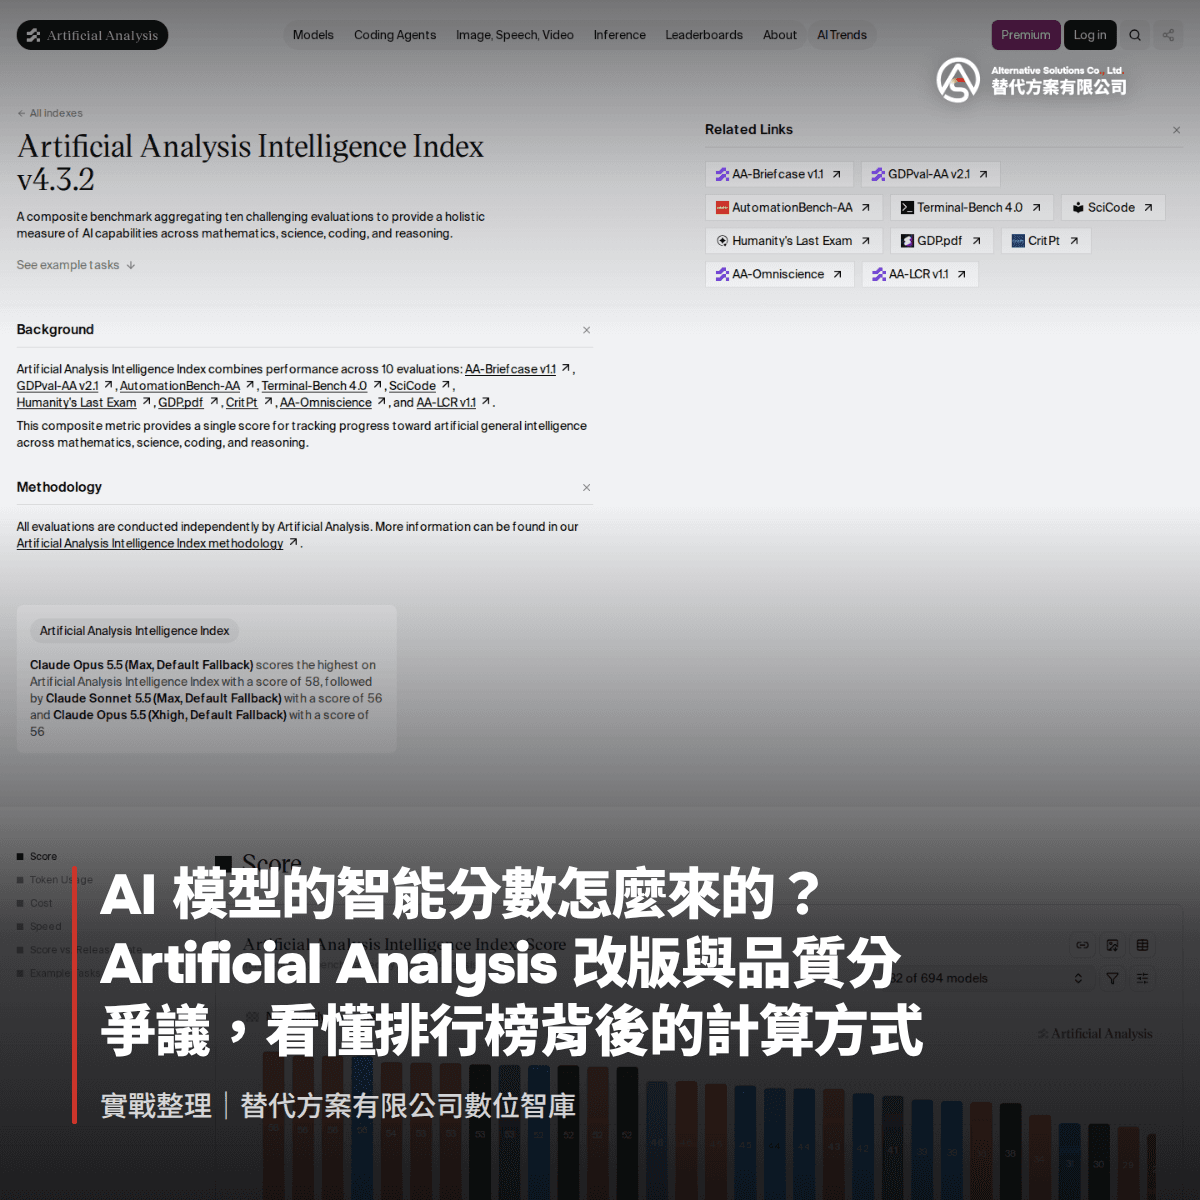
同一批模型的分數突然一起往下掉,Artificial Analysis 在 2026 年 9 月改了什麼
9 月中看到某個模型的分數比 8 月少幾分,先別急著說它退步。2026 年 9 月 7 日,專門替 AI 模型打成績的 Artificial Analysis(以下稱 AA)把 Intelligence Index(智能指數,用一組標準題庫替模型打總分)升到 v4.3,幾乎所有模型的分數同步下探,原因不是模型變笨,而是考卷換了。
改動有兩塊。一是題目本身,Terminal-Bench 從 2.1 換成 4.0,這項目考模型能不能在命令列環境完成任務,新版題目更長、更貼近真實除錯情境,難度基準自然不同。二是部分評測項目整批替換,題庫組成跟著改變。智能指數是多項測驗加權出來的總分,只要其中一項被換掉,基準線就會移動,這是全體分數一起下滑的主因。
為什麼舊文章的數字不能直接拿來比
智能指數的分數是相對值,不是絕對值。同一個版本內,58.9 跟 57.6 比得出高下;跨版本相比,就像拿今年的學測成績去對三年前的錄取分數,看起來都是數字,立足點卻不一樣。許多排行榜與評測文章沒有標版本,讀者拿改版前的分數去對改版後的分數,很容易誤判某個模型退步,其實只是題目變難。
看分數前先確認三件事:指數版本、抓取日期,以及是不是同一份題庫算的。截至 2026 年 10 月,AA 官網與主要排行榜多半會標版本,轉載文章卻經常省略這行小字。企業若想拿分數當採購依據,建議自己建一張表,把版本號和日期一起記錄,半年後回頭看,才知道哪些數字還能用。
| 項目 | 改版前 | 改版後(v4.3) | 對分數的意義 |
|---|---|---|---|
| 終端機操作測驗 | Terminal-Bench 2.1 | Terminal-Bench 4.0 | 題目更新、難度基準提高 |
| 部分評測項目 | 舊題組 | 整批替換 | 加權組成變動,總分基準移動 |
| 跨版本比較 | 可與同期分數對照 | 只建議同版本內比較 | 舊文數字須標註版本才能引用 |
智能分數是怎麼打出來的:一份成績單的組成
打開任何一份 AI 模型排行榜,你會看到一個兩位數分數,例如 58.9 或 44.8。這是智能指數(Intelligence Index),由獨立評測機構 Artificial Analysis 定期公布,把幾十個模型壓縮成一條能排序的直線。它不像學校段考只有一份考卷,而是把十幾種不同性質的測驗合併成一個代表值,方便你在短時間內判斷誰在前段班。
以 2026 年 10 月的版本 v4.3.2 為例,考題分四類:文字推理、程式撰寫、知識問答,以及工具操作。工具操作最常被忽略,它要求模型在模擬的終端機環境完成指令任務,考驗能不能動手做,而不是能不能講得漂亮。每一類底下還有好幾份試卷,各自產生原始分數,再送進同一個合併流程。
總分是加權合併,不是各項平均
這些原始分數不是相加除以項目數,而是先依難度與代表性給權重再合併。理由很實際:各份考卷的題數與猜對機率不同,等權平均會讓容易的項目主導結果。加權之後,總分反映的是評測機構認為重要的事,不是全能程度。於是可能出現某個模型程式項目排前三,卻因為工具操作普通,總分被拉到第五。它不是變笨,是被拉去考了不擅長的科目。
那分數差多少才算有差?截至 2026 年 10 月,榜首 GPT-5.6 Sol 是 58.9,Claude Opus 5.5 約 57.6 至 58(benchlm.ai,2026-10)。兩者相差 1 分上下,在這種合併式指標裡屬於雜訊等級,不會因為這 1 分讓你的客服機器人突然開竅。真正該注意的是十幾分的級距,那代表能力斷層,例如開源權重模型 GLM-5.3 的 44.8。
看分數時記得帶著版本與日期,否則很容易拿不同年度的考卷比排名。
同樣叫品質分,三家榜單給出三個不同的榜首
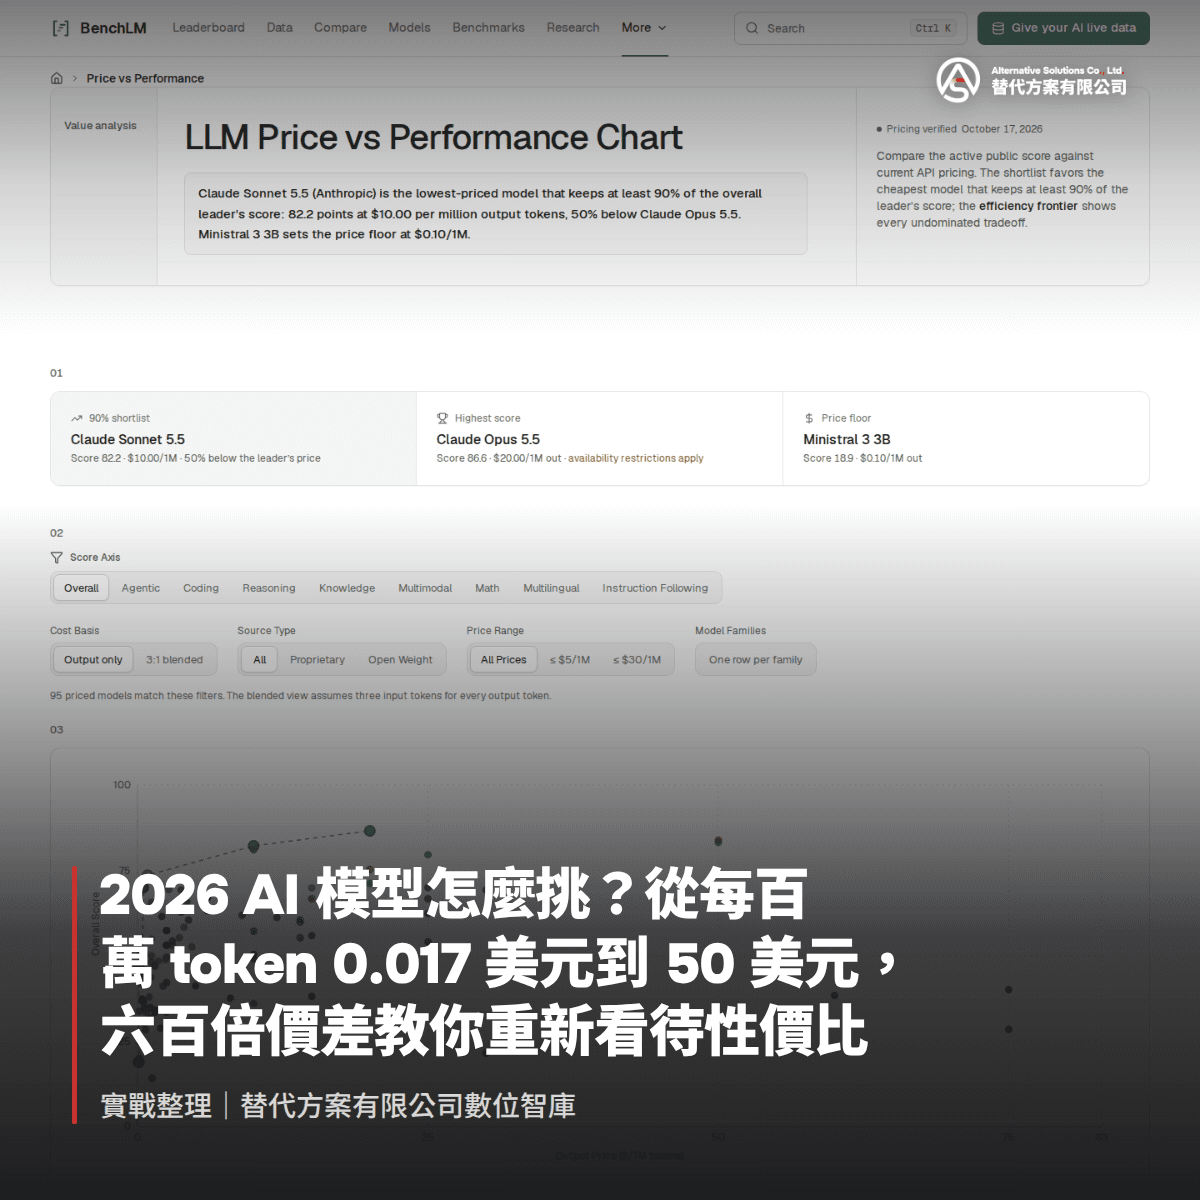
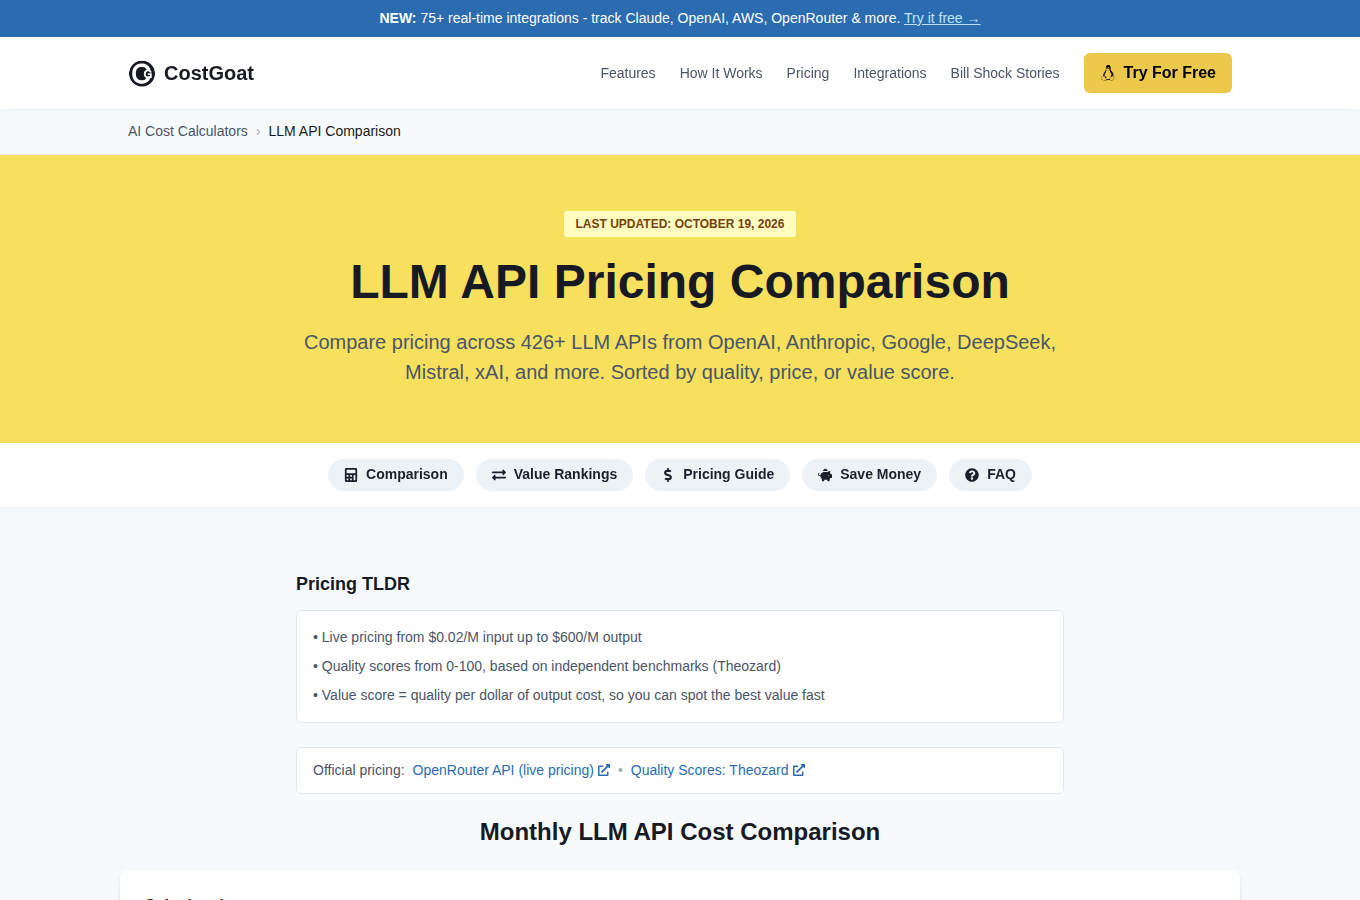
2026 年 10 月打開三個模型比價網站,會看到三張榜首完全不同的表。先講 benchlm.ai,它是一個把模型分數與 API 價格並排的比較站,算法最單純,結論是阿里 Qwen3.7 Flash 性價比最高;costgoat 同樣比性能與價格,但先設了品質門檻,冠軍換成 DeepSeek V4.1 Flash;至於獨立評測機構 Artificial Analysis,它只排智能指數、完全不看價格,前段班仍是 Claude Sonnet 5.5 這類旗艦模型。不是誰造假,是三家在回答不同的問題。
更新日期也不同。AA 的改版發生在 9 月,動的是題庫;benchlm 與 costgoat 是 10 月中才更新價格,動的是分母。兩邊時間軸錯開,拿不同日期的數字互比,很容易得到錯誤結論。
benchlm 的算法最直白,把分數除以每百萬 token 輸出價,算的是「每花一塊美元買到幾分」。Qwen3.7 Flash 拿 46.93 分、輸出價 $0.13,除下來 361 分登第一;MiMo-V2.6-Flash 64.51 分、$0.28 換算 230 分第二;Mercury 2.5 33.77 分、$0.15 換算 225 分第三。這三個數字攤開看,Qwen3.7 Flash 的分數其實只比 Mercury 2.5 高十幾分,名次差距主要來自價格低了一截,不是能力強一大截。反過來看,Claude Haiku 5.5 拿到 70.04 分,分數全場最高,但輸出價 $0.50 把它的每美元得分壓到 140 分、掉到第六。分母小,分數不必高也能衝榜,這張表本質上是便宜優先的邏輯。
costgoat 先設門檻再比價,模型要達到一定可用品質才進榜。DeepSeek V4.1 Flash 以品質 68、輸出價 $0.14 換算 472 分排第一;GLM 5.3 Flash 品質 73、輸出 $0.18 換算 405.6 分第三;GPT-6 Luna 批次價 $0.25、品質 65 換算 260 分第五。這裡也有一個容易被誤讀的地方,GLM 5.3 Flash 的品質分比分數較高的對手更高,名次卻排在後面,差別全在那 0.04 美元的輸出價。門檻擋掉了便宜但難用的選項,但門檻畫在哪裡,結果就會整個翻過來。
Artificial Analysis 走第三條路,用 Intelligence Index 綜合分數做絕對排名,價格完全不進分母。Claude Sonnet 5.5 的 56.0 分因此在這種排序裡靠前,在前兩張表卻擠不進前段,原因很單純:它的輸出價每百萬 token 要 10 美元,放進除以價格的算式一定吃虧。這也說明一件常見的誤解,貴不等於強,只是貴的模型在比價表上不吃香。
同一個模型,三張表的名次差多少
| 模型 | benchlm 分數÷輸出價 | costgoat 品質÷輸出價 | Artificial Analysis 智能指數 |
|---|---|---|---|
| Qwen3.7 Flash | 361,第 1 名 | 未進前段 | 未進前段 |
| DeepSeek V4.1 Flash | 54.7,第 18 名 | 472,第 1 名 | 未進前段 |
| Claude Sonnet 5.5 | 另一組算法第 1 名 | 未進前段 | 56.0 分 |
名次落差不是誤差,是三種價值觀的具體化。DeepSeek V4.1 Flash 在 benchlm 只排第 18,在 costgoat 卻是第 1,中間隔了十七個名次。差別出在兩邊認定的版本不同:benchlm 計入的是輸出價每百萬 token 1.20 美元的那個版本,算出來 54.7 分;costgoat 用的是 0.14 美元的 Flash 版,同一顆模型算出 472 分。名字一樣、價差將近九倍,名次當然翻過來。看榜單前先問自己「要省錢還是要最強」,答案不同,該看的那張表就不同。
讀排行榜最容易踩的四個坑,以及怎麼自己查證
排行榜本身沒問題,問題出在抄數字的人。少抄一個日期或分母,結論就會反過來。以下是整理 2026 年 10 月資料時最常看到的四種誤用。
第一個坑是把舊分數當成現在的分數。前面提過 9 月的改版讓全體分數下修,實際出錯的場景長這樣:你拿 8 月文章寫的 60 幾分,去比 10 月榜上的 58.9,然後判斷某個模型退步了。真正換掉的是量尺,不是模型。
第二個坑是把不同榜單的分數放進同一張表。同樣叫性價比,benchlm 用分數除以輸出價,costgoat 用另一套品質分除以輸出價,冠軍因此一個是 Qwen3.7 Flash、一個是 DeepSeek V4.1 Flash。更常見的是把 Claude Sonnet 5.5 的 82.2 分跟 AA Index 的 56.0 分並列,兩者根本不是同一把尺。
第三個坑是看到「開源最高分 46.3」就引用,卻沒確認那是哪個模型、多少參數、什麼授權。該篇報導只寫了分數、沒指名型號,而查得到、有名有姓的開源高分是 GLM-5.3 的 44.8 分。型號沒確認前,這數字不能當採購依據。
第四個坑是把廠商公布的品質分當成 Intelligence Index。GPT-6 Astra 的 91、Claude Fable 5.1 的 93 是 costgoat 的品質分,跟 AA Index 的 58.9 不同量尺,混著寫會讓讀者以為某個模型贏了 30 幾分。
自己查證的四個動作
養成四個習慣就能避開:每個分數註明抓取日期與索引版本;比較前確認分母是輸出價、輸入價還是混合價;模型名稱寫到完整版本號,GPT-5.6 Sol 與 GPT-6.1 Sol 是不同東西;只寫分數、不寫量尺的榜單,回頭找原始頁,找不到就別用。榜單能幫你縮小範圍,但沒有一個數字能替你決定,先算出自家工作的輸入輸出比例,再回頭看哪張表的分母最像你的帳單。
替代方案有限公司觀點:分數是採購參考,不是規格書
客戶拿著排行榜第一名來問「是不是該換成這個」,我們通常先反問:你現在用的模型在這份榜單上排第幾。排行榜不是替你挑冠軍,而是幫你確認兩件事,現有模型有沒有明顯落後,以及有沒有分數接近但便宜一截的替代品。
我們判斷該不該換的三個門檻
第一個門檻是分數差距。截至 2026 年 10 月,榜首與第二名的差距不到 1.5 分,這種差距在我們的實測裡幾乎感受不到,卻要付出整組提示詞重調的成本。差距拉到 5 分以上才算跨了一個級距,值得啟動評估。
第二個門檻是價錢。2026 年 10 月 modelgrep 與 costgoat 的資料都顯示,GPT-6 Astra 輸出價每百萬 token 是 50 美元,GPT-6.1 Sol 只要 10 美元,而兩者品質分是 91 對 90。差一點分數、差五倍價錢,這種組合才是我們會主動建議客戶評估的對象。
第三個門檻最常被忽略:分數相同不代表在你家的任務上表現相同。榜單考通用題庫,你的工作是客服回覆、合約摘要或財報整理,難點跟考題不同。我們一律先拿自家 30 到 50 筆真實案例跑一輪,過了才談換模型。
給台灣團隊的落地建議是分級派工,別讓整套系統綁在同一顆模型上。內部知識查詢、信件草稿這類容錯高的任務,用每百萬輸出 1 美元以下的入門模型就夠;對外客服與程式碼產生,才值得付到 10 美元的中價位。分級會拉高系統複雜度,維運人力不足的小團隊先用一顆中價位模型打天下,反而比較實際。
還有個現實:分數會改版,價格也會降。2026 年 9 月 OpenAI 把 GPT-6 Sol 與 Luna 降價五成,任何寫死在規格書裡的比較表半年就過期。分數當參考座標就好,規格書留給你自己跑出來的實測結果。
常見問題 FAQ
Q:智能分數會不會變?我看到的數字跟別人貼的不一樣,是怎麼回事?
會變。9 月那次改版之後,全體模型的分數都往下掉,所以拿改版前文章裡的數字去對現在的榜單,對不起來是正常的。截至 2026 年 10 月,GPT-5.6 Sol 以 58.9 分暫居第一,Claude Opus 5.5 大約 57.6 到 58 分,不同來源之間還會有一點出入。看分數最好連時間一起看,標個「截至 2026 年 10 月」或加個「約」,才不會拿著舊數字跟人家爭。
Q:為什麼每個網站講的「性價比第一名」都不一樣?
因為分子跟分母放的東西不同。benchlm.ai 用智能分數除以輸出價,第一名是 Qwen3.7 Flash;costgoat 用另一套品質分除以輸出價,只納入達到門檻的模型,冠軍變成 DeepSeek V4.1 Flash;benchlm 還有第三種算法,找保留領先者九成分數的模型裡價格最低的,結果是 Claude Sonnet 5.5。不是誰算錯,是三家在回答不同的問題。先看自己的用量形狀偏輸出還是偏輸入,再挑算法接近的榜單,不要只看第一名就決定。
Q:榜上的「品質分」跟「智能分數」是同一件事嗎?
不是,不能混著比。智能分數是 Artificial Analysis 那套綜合評測算出來的,GPT-5.6 Sol 的 58.9 就是這個。品質分則是像 costgoat 這類網站自己另外給的,GPT-6 Astra 的 91、Claude Fable 5.1 的 93 都屬於品質分。兩套尺規不一樣,直接比高低沒有意義,看榜之前先確認那個數字是哪一家、哪一套指標算出來的。
📩 有任何問題或需要協助,歡迎聯絡我們:[email protected]
Related