先留驗證額度再派搜尋代理:security-audit-skill 用代理呼叫次數編預算,quick、standard、deep 三檔怎麼挑才不會跑到一半卡住
目錄
共 11 個章節
為什麼資安稽核會跑到一半卡住:代理呼叫次數就是你的預算
第一次用這套技能的人,常遇到同一個畫面:AI 跑了半小時,報告寫到一半忽然停下,說額度不夠。多數人第一反應是網路斷了或模型出錯,其實卡住的地方幾乎都在驗證階段,因為前面的搜尋已經把代理呼叫次數用光了。
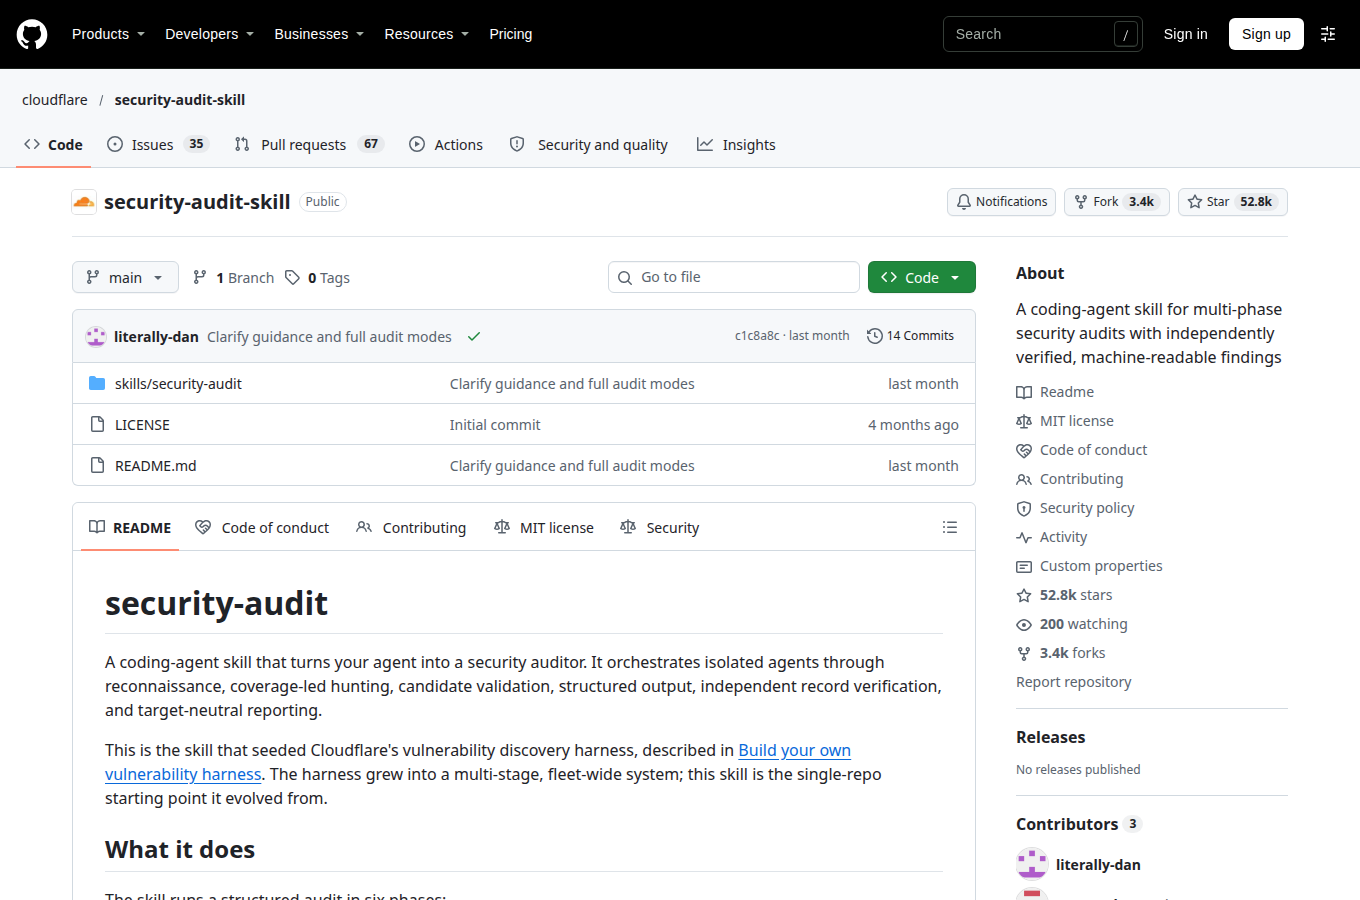
它並不是從頭跑到尾的掃描程式。這套技能把資安稽核拆成六個階段,每一段交給新開的子代理接手,而每開一個新代理就得重讀一次專案脈絡。所以你真正在消耗的資源不是算力,是「還能叫幾次代理」。
額度被吃掉的方式很具體。一個覆蓋單位大約等於一次搜尋代理呼叫,一個候選漏洞則要一到兩次驗證代理呼叫。搜尋階段會浮出一堆看起來可疑的地方,很多人一開始就把額度全押在搜尋上,等到要驗證時才發現沒子彈。問題不在工具壞了,在預算配錯了。
官方要求先編預算再開工
技能文件寫得很直白:派搜尋代理之前,要先把評論者與驗證階段的額度留下來,額度不夠就不要派。寧可少查幾個覆蓋單位,也不要把驗證環節餓死。沒經過對抗式驗證的報告,等於把「可能有問題」當成「確定有問題」,比不跑更危險。
額度真的不夠時,正確做法不是硬跑完,而是把該次執行標記為 incomplete,並在報告裡說明哪些覆蓋單位沒查、哪些候選沒驗。quick、standard、deep 三種檔次的差別,其實就在驗證額度要留得多寬。Cloudflare 在自己的測試裡提到,單次執行大約只找到重複執行總量的一半漏洞,所以 incomplete 是這套流程的常態,不是故障。
預算怎麼算:一個覆蓋單位、一個候選漏洞各吃掉幾次呼叫
講 AI 稽核時,大家習慣問「要跑多久、花多少錢」,這套技能改用第三種算法:把代理呼叫次數當預算單位。時間和費用會隨模型速度、程式碼長度浮動,呼叫次數卻能在開跑前規劃、中途喊停,交出去的不再是一個截止時間,而是一張「還能叫幾次代理」的額度表。
換算分成兩塊。第一塊是第二階段的覆蓋式搜尋。技能把系統拆成一個又一個「覆蓋單位」,也就是一份獨立的檢查範圍,例如一個對外輸入介面、一條金流路徑。每個覆蓋單位大約對應一次搜尋代理呼叫;清單切得越細,呼叫次數越多,切得太粗則容易漏掉邊角。
第二塊落在候選漏洞身上。搜尋代理回報一個疑似問題,第三階段就交給全新的驗證代理,任務是想辦法推翻它,這一步約吃掉一到兩次呼叫,實際數字依檔次而定。順序在這裡是關鍵:官方要求先保留覆蓋評論者與驗證的額度,剩下的才拿去派搜尋。驗證是把雜訊濾掉的關卡,額度若先被搜尋吃光,等於找了一堆疑點卻沒人查證。
開跑前先粗估一次,再按下執行
兩塊加起來,就能在開跑前得到一個數量級。假設專案切出 40 個覆蓋單位、預期冒出 10 個候選漏洞,搜尋約 40 次、驗證約 10 到 20 次,再加上評論者的固定開銷,整體概估落在 60 次上下。這個數字不是精算結果,卻足以判斷額度夠不夠。不夠就縮小範圍、先跑 quick 檔次,或直接把執行標記為 incomplete。
只盯著「找到幾個漏洞」而沒先算呼叫次數,很容易在驗證階段才發現額度見底,拿到一份滿是 needs_validation 的報告。它不是沒價值,離「能當驗收附件」還有一段落差。想先搞清楚六個階段各自在做什麼,可以參考拆開六個階段:security-audit-skill 從畫架構、切覆蓋單位到產出 findings.json,agent 到底照什麼順序做事,把流程順序看完再回頭算預算會清楚很多。
quick、standard、deep 三檔怎麼挑:一張表看懂差別
跑資安稽核跟健康檢查一樣,做多細得看你是例行走檢,還是已經懷疑某處出了狀況。這套技能提供 quick、standard、deep 三種檔次,差別在於派幾組搜尋代理、驗證代理查得多深。挑錯的代價很具體:用 quick 硬跑大型專案,覆蓋清單還沒掃完額度就見底,報告只能標記 incomplete;用 deep 跑小改動,則是把預算倒進不需要這麼細的題目。
三檔分野不在「找得準不準」,而在覆蓋廣度與驗證深度。依官方 repo的說明,quick 對應小型目標、重複執行、先看一眼現況;standard 是預設值,適合一般專案;deep 留給高風險或大型目標。這是一條從快篩到完整體檢的光譜,不是品質評分。
| 檔次 | 適合的情境 | 你該有的期待 |
|---|---|---|
quick |
小型目標、改版後重跑、先確認方向 | 速度快、覆蓋面窄,適合當第一輪暖身 |
standard |
一般專案、交付前的自我檢查 | 官方預設值,多數團隊從這裡開始 |
deep |
高風險系統、大型或跨服務目標 | 驗證層層加厚,呼叫次數與時間明顯增加 |
三個問題,決定你按哪一檔
第一個問題是範圍:專案有幾個服務、幾條信任邊界、幾個對外輸入介面。一隻手數得完,quick 就夠;橫跨前端、後端與雲端設定,就別勉強。第二個問題是出事的代價:金流、會員個資或對外服務,值得用 deep 換更厚的驗證;內部工具或示範專案,standard 已經夠。第三個問題是手上的代理呼叫額度,檔次直接決定呼叫次數,額度不足硬開 deep,驗證階段往往做不完。
不確定就從 standard 起步,跑完一輪再依覆蓋清單中沒查完的部分調整。deep 也不是一次到位,補跑與紀錄才是完整性的來源。驗證到底怎麼運作、為什麼每個結論都要被推翻一次,可以看找到漏洞的 agent 不能自己說算:security-audit-skill 派全新驗證代理專門推翻結論,推不翻才進 confirmed 清單。
實戰順序:先保留驗證額度,再派搜尋代理
檔次決定呼叫次數,順序則決定這些次數有沒有花在刀口上。官方流程寫得很明白:先保留給覆蓋評論者(coverage critic)與驗證代理的額度,剩下的才派給搜尋代理。搜尋階段很容易失控,每個覆蓋單位看起來都值得查,額度一路派到見底,結果找到一堆候選卻沒人手推翻,只能全部塞進 needs_validation。這種報告讀起來很豐富,實際上沒有一筆真的被驗證過。
所以開跑前第一件事不是下指令,是先估數。覆蓋清單建好後,你會知道目標切成幾個獨立單位,一個單位大約等於一次搜尋代理呼叫;再依專案規模預估候選數量,每個候選大約需要一到兩次驗證呼叫。兩者相加才是這一輪真正的成本,而不是只算搜尋那一半。覆蓋清單不只是給搜尋代理看的地圖,同時也是一張預算表。
額度快用完時的收尾方式
跑到一半發現額度不夠,最糟的處理方式是「湊完再說」。官方要求額度不足就不要派,並把該次執行標記為不完整(incomplete),不准宣稱完整覆蓋。實務收尾順序是:停止派新的搜尋代理,把已找到的候選全部送進驗證,讓每一筆都拿到結論;報告裡寫清楚哪些覆蓋單位還沒查、哪些結論還沒經過獨立重驗,把缺口留成下一輪的待辦清單。
這樣一來,每一筆 confirmed 都站得住腳,沒查完的部分也一目了然。為了讓報告好看而跳過驗證,等於把風險藏起來,誠實標記遠比一份漂亮的假完整有價值。
這套技能也不能對著正式站跑,它對執行環境有明確的沙箱要求,細節寫在AI 稽核不能直接對著正式站跑:security-audit-skill 把目標程式關進無網路沙箱、原始碼只准唯讀,缺沙箱就寫進 needs-validation,開跑前先看完再動手。
替代方案有限公司觀點:台灣團隊怎麼選檔次、怎麼交代
前面談的都是工具怎麼運作,這裡談我們在客戶現場看到的情況。三種檔次白話說就是「先看一眼」、「照標準跑」與「高風險加碼」,差別在於你願意花多少代理呼叫次數。我們的經驗是,多數台灣中小企業不是選太淺,而是選太深,跑出一份沒有人要看的報告。
先說外包驗收。這個場景要的不是找齊所有問題,而是一份能附在驗收單後面的清單,所以 standard 通常夠用;若合約金額大、系統會碰到金流或個資,再上到 deep 才合理。老系統交接適合先跑 quick,重點不在漏洞數量,而在它產出的架構檔與覆蓋清單,讓接手的人知道系統邊界在哪裡。這比一份沒人看得懂的漏洞列表實用。
至於上線前檢查,我們建議固定用 standard,並當成流程裡的一個檢查點,而不是一次性任務。很多人以為跑完就沒事,但這套流程本來就假設要跑不只一輪,價值在於把清單留著、下一輪接著查。
我們認為,紀錄比跑完一次更值錢
我們的觀察是,台灣多數中小企業的資安預算集中在「有事件才處理」,平時根本沒有定期檢查的科目。這套做法把「平時留下紀錄」的成本壓得很低,邊際成本主要是人看報告的時間。不過缺點也要講清楚:如果沒有指定誰來看報告、誰來決定哪些 confirmed 要修,產出的檔案只會靜靜躺在資料夾裡。
所以落地建議是這樣。先指定一位負責人,不一定要工程師,但要讀得懂 needs_validation 代表「有疑點還沒查清」;再把覆蓋清單放進交接文件,因為它記錄了查過什麼、漏了什麼;執行環境則回到沙箱條件,做不到就別在正式站上跑,這是我們最常看到的錯誤。
常見問題 FAQ
Q:三檔要怎麼挑,才不會跑到一半卡住?
關鍵在它的預算算法。這套技能用代理呼叫次數當預算單位,一個覆蓋單位大約等於一次搜尋代理呼叫,一個候選漏洞約一到兩次驗證代理呼叫。官方要求先保留評論者與驗證的額度,再派搜尋代理;額度不夠就不派,並把該次執行標記為 incomplete。所以會卡住,通常是一開始就派了太多搜尋代理。挑選方式很直白:quick 適合小型目標與重跑,standard 是預設值,deep 留給高風險或大型目標。
Q:跑這個會不會把公司的程式碼傳出去?
技能本身明文規定原始碼檢視是唯讀的;要跑建置、測試或模糊測試,只能在作業系統層強制的沙箱裡,而且必須沒有對外網路、空環境啟動、目標與工具鏈唯讀,還要限制 CPU、記憶體與執行時間。做不到這些控制就不能執行目標程式碼,得把「缺沙箱能力」寫成 needs-validation 的阻礙。至於程式碼會不會送到模型端,取決於你用的 coding agent,不是這份技能能決定的。
Q:跑一次就等於稽核完了嗎?它跟一般的漏洞掃描器差在哪?
不是。官方在 repo 裡寫明,在他們自己的測試中,單次執行只涵蓋重複執行總量的一部分,若沒有前次清單,報告裡就要說明,不能暗示「跑過一次就沒事」。它也不是掃描器,而是一份把資安稽核拆成六個階段的作業手冊,加上兩支零依賴、只驗輸出格式的 Node.js 腳本。最大的差別在對抗式驗證:每個候選漏洞都交給沒參與搜尋的全新驗證代理,任務是想辦法推翻它,推不翻才留下;結論分成 confirmed、needs_validation、rejected 三類,其中 needs_validation 只寫明未解的事實,不給嚴重度。
📩 對這套流程怎麼用在你的專案上有疑問,歡迎寫信給我們:[email protected]
Related