Jev 的獨立實測:宣傳的快 193 倍站得住嗎
目錄
共 13 個章節
「快 193 倍」的原始情境:官方數字是跟誰比、在什麼任務上比
你大概在社群上看過「Jev 比大型語言模型快 193 倍、便宜 444 倍」這個說法。這兩個數字確實寫在 TypeSafe 官方發布稿裡(2026-09-15),但它們有非常特定的出場條件。把它們抽離原本的語境轉述,就註定會誤解這個模型。
那是自家管線的峰值,不是通用成績
先講結論:193.6 倍與 444.6 倍,是 TypeSafe 拿自家內部某一條工作流程實測,在峰值狀態下量到的差距,比較對象是用前沿模型做同一件事。所謂峰值,指的是那條管線上表現最好的一刻,不是平均,也不是隨便換一個任務都能重現。
換句話說,官方比的是「我們自己設計的一條管線」,而不是「所有人都在做的通用任務」。同一份官方資料另外給了比較保守的區間:一般狀況下快 40 至 200 倍、便宜 40 至 400 倍。193.6 倍落在這個區間的上緣,屬於官方自己定義的最好情況。官方的說法可以在發布稿裡逐字對照。
官方自曝的準確率落差,才是查核的起點
另一組更關鍵的數字同樣來自官方:自家 benchmark 上,Jev 的準確率是 67.8%,最佳比較模型是 74.1%,差距 6.3 個百分點。快 193 倍與準確率較低這兩件事同時成立並不矛盾,因為它們量的是不同的東西,一個量速度,一個量答對的比例。
這個自我揭露反而成了後續所有獨立查核的起點。八天後的獨立盤點(dev.to,2026-09-23,彙整 14 篇 arXiv 預印本與 104 個 GitHub 評測)指出,官方宣稱的倍數在獨立基準上沒有出現過;ayautomate 的 791 筆決策實測(2026-09-19)量到的是中位快 2.0 到 3.6 倍。把各家獨立測試擺在一起,速度區間落在「比跑在迷你電腦上的本地模型慢一半」到「快 12.1 倍」之間,成本則是「貴 0.6 倍」到「便宜 478 倍」都有。
方向沒錯,幅度差很遠。而且 193.6 倍講的是速度,444.6 倍講的是帳單,兩個數字不是同一個任務、也不是同一組對手。這也是為什麼接下來要一路看成本、看案例、看獨立實測,而不是只盯著那一個 193。
四份可查核的獨立實測:誰做的、量了什麼、結果怎麼讀
「獨立實測」分三層:第一方自測、第三方但由 launch partner 執行、預先註冊且程式與帳單公開,只有第三層能逐項重算。
樣本規模與量測條件並排
| 來源 | 性質 | 量了什麼 |
|---|---|---|
| ayautomate(2026-09-19) | 第三方獨立,程式與原始結果公開 | 791 筆決策、3,955 次呼叫、花費 1.53 美元 |
| Suraj 客服分流實驗 | 第三方獨立,預先註冊、程式公開 | 每輪 300 張票、2 秒截止、8 個並行工作 |
| Every 編輯部檢查 | 第三方獨立,作者是 launch partner | 37 篇文章、21 道問題、共 1,709 個判斷 |
| dev.to 八天盤點(2026-09-23) | 第三方彙整,不是原始實驗 | 14 篇預印本、104 個 GitHub 評測 |
ayautomate(2026-09-19):8 類意圖路由 160 筆、77 類路由 231 筆、prompt injection 偵測 400 筆,共 3,955 次呼叫、1.53 美元。Jev 中位快 2.0 到 3.6 倍、比兩個最便宜的小模型便宜 4.7 到 7.5 倍,準確度相當,但 77 類路由比 GPT-5.6 Terra 低 5 分;官方說的 193.6 倍沒有出現。
它最有價值的發現是信心分流:只讓 Jev 回答信心 0.80 以上的題目,其餘轉給 GPT-5.6 Terra,準確度等於全程用 Terra,成本只要 26 到 28%,平均延遲約一半。
Suraj 的預先註冊實驗用 CLINC150 銀行類 30 類加一類「不在此範圍」,到達率 2 到 40 張/秒、2 秒截止、8 個並行工作:每 1,000 個又快又對的決策,Jev 高負載下 0.048 美元,Claude Haiku 4.5 要 1.70 美元;但 Jev 範圍內準確率 92.1%,輸 Haiku 的 93.6%,五個模型只差 3.4 個百分點,Jev 的優勢在高負載、時間預算緊時。
Every 最乾淨:主編 Dan Shipper 用自家 37 篇文章與 21 道問題做成 1,709 個判斷,不到 1 美分,中位每段 0.35 秒(Fable 5.1 是 8.83 秒),7 個植入缺陷抓到 6 個,約快 25 倍、便宜 600 倍;作者是 launch partner,動機要留意。dev.to 八天盤點是二手整理,但點出官方 integration 的 100% 正確率其實是 5 個案例重複跑 100 次、「快 15.9%」出自 TypeSafe 員工自己的 3 個案例、Nimble 由賣家自評。
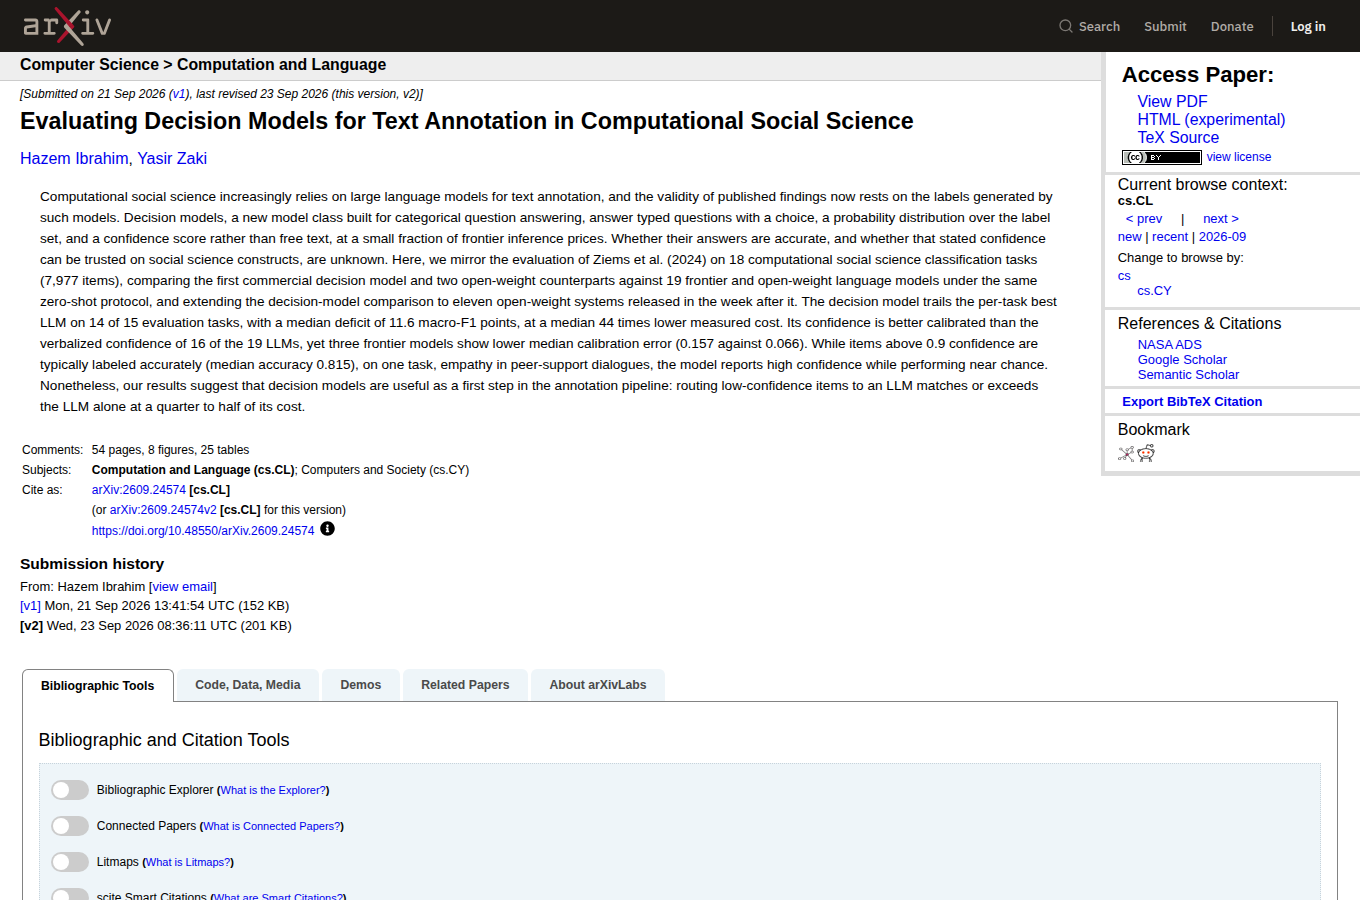
另兩份:arXiv 2609.24574(Ibrahim 與 Zaki)用 7,977 筆人類標註任務,Jev 在 15 個任務中 14 個落後 19 個 LLM 中最好的那個,中位差 11.6 個 macro-F1 分,同價位帶的 Gemma 4 31B、Qwen3 235B 分別高 3 分與 2 分;Janardhan 的 200 筆六模型比較,Jev 準確率 72.5%、ECE 0.161,對比 Claude Fable 5.1 的 84.0% 與 0.064。
讀法:看得到程式與帳單的數字可以信,只有作者自報的先記著;中文與台灣場景四份都沒測過,導入前要自己補。
速度、成本、準確度逐項對照:哪些數字站得住
官方說法是快 40 到 200 倍、便宜 40 到 400 倍(TypeSafe AI,2026)。第三方重測之後,區間鬆到讓人以為看錯:速度從「比跑在迷你電腦上的本地 Gemma 4 26B 還慢一半」到「快 12.1 倍」,成本從「貴 0.6 倍」到「便宜 478 倍」。差這麼大不是誰說謊,是比誰、比什麼任務、在哪裡計時。跟一個會完整思考再回答的模型比,Jev 當然快得離譜;跟一個只吐一個分類標籤的小模型比,它可能還慢。
速度與成本:絕對值比倍數有用:對要下決定的人來說,倍數沒意義,秒數才有。伺服器本身約 105 毫秒,扣掉網路往返約 76 毫秒。成本端,社群自行維護的目錄站統計 15 個公布帳單的專案,中位每筆決策 0.000068 美元,換算下來一美元約一萬四千七百筆。最省的是 Every 編輯部那 1,709 個判斷,不到 1 美分;最貴的是 100 封郵件詐騙偵測 0.07 美元,因為每封信都得讀完整封。
準確度與校準:兩件不能混為一談的事
官方自己的 benchmark 是 67.8%,最佳比較模型 74.1%(TypeSafe AI,2026)。arXiv 上規模最大的預先註冊研究(2609.24574,2026)用 7,977 筆人類標註的社會科學標註任務測試,Jev 在 15 個任務中有 14 個落後 19 個 LLM 中最好的那個,中位差距 11.6 個 macro-F1;同價位帶的 Gemma 4 31B 與 Qwen3 235B 還比它高 2 到 3 分。
Janardhan 的 200 筆六模型比較(2026)把兩件事拆開量。準確率是答對的比例;校準誤差(ECE,越低越好)問的是「它說八成有把握時,是不是真的對八成」。
| 模型 | 準確率 | 校準誤差(ECE) |
|---|---|---|
| Claude Fable 5.1 | 84.0% | 0.064 |
| GPT-6 Astra | 79.0% | 0.119 |
| DeepSeek V4.1 Flash | 76.0% | 0.138 |
| MiniMax M3 | 75.5% | 0.112 |
| Kimi K3 | 74.5% | 0.119 |
| Jev | 72.5% | 0.161 |
Jev 在這張表上兩欄都墊底,但八天獨立盤點(dev.to,2026)的說法是,它在熟悉的英文任務上校準度是所有受測模型中最好的。兩份來源不一致,指向同一件事:校準會隨任務分布跑掉,離開熟悉情境就雙向偏錯,用幾百筆標籤擬合一個溫度參數,能修掉大部分誤差。
官方宣傳站不住的三件事,與實測真正找到的一件事
dev.to 八天系統性盤點(14 篇 arXiv 預印本、104 個 GitHub repo、33 篇文章):Jev 準確度與中價位 LLM 同級,乾淨比較中落後前沿模型 6.5 到 11.5 分;校準度在熟悉的英文任務最好,離開分布會雙向偏錯,用 50 到幾百筆標籤擬合 temperature 能修掉大部分誤差。
官方三大宣傳站不住。一,「不會幻覺」是行銷語言:只回傳事先定義的欄位與選項,仍可能挑到合法卻錯誤的答案,型別安全管格式不管正確。二,70 毫秒對 329 秒是單一判斷比完整思考鏈,任務不對等;實際速度落在「比本地 Gemma 4 26B 還慢」到「快 12.1 倍」,伺服器約 105 毫秒、扣掉網路往返約 76 毫秒。三,20 到 200 倍快、40 到 400 倍便宜來自 TypeSafe 自我測試(2026),量的是與前沿模型的答案一致程度;官方自曝自家 benchmark 67.8%、最佳比較模型 74.1%,官方弱點頁比宣傳稿誠實,獨立的 Every 測試(2026)只有約快 25 倍、便宜 580 倍。
官方弱點頁自列失敗模式:照字面讀、數數與日期不可靠、上下文會腐蝕、狀態可被操縱、不生成。技術不是護城河:vLLM 用 logprob_token_ids、SGLang 用 /v1/score、Featherless 的 SimpleJev 就能做,開源 Kev、Nimble、Luce 已有數千顆星;310M 日文 encoder 用 200 筆訓練贏 Jev 12 分,釣魚偵測兩行正規表達式 91.6%、Jev 62.6%。成本上社群中位每筆 0.000068 美元,1kpapers 摘要 3.99 美元、分類 0.08 美元,差 50 倍。
真正站得住的是信心分流
ayautomate(2026-09-19,791 筆決策、3,955 次呼叫、1.53 美元):只讓 Jev 處理信心 0.80 以上的題目,其餘轉給前沿模型,準確度等於全程用前沿模型,成本只要 26 到 28%,延遲約一半。官方 193.6 倍與 444.6 倍在此沒出現;信心分數是可調旋鈕,是台灣團隊同時談成本與準確率的切入點。
Suraj Phanindra 的客服分流預先註冊實驗(CLINC150 銀行類 30 類加一類「不在此範圍」,2 秒截止)用「每 1,000 個又快又對的決策成本」計分:Jev 0.048 美元、DeepSeek V4.1 Flash 0.414 美元、GPT-5.6 Luna 0.156 美元、Claude Haiku 4.5 1.70 美元;五個模型範圍內準確率只差 3.4 個百分點,Jev 92.1%、Haiku 93.6%。台灣可對應客服分流、表單分類(choice)、內容審核(score)、轉真人(noul)。但書:要先有量測辦法;選項不固定或需生成文字不適用;中文無人實測,導入前需自家資料小規模驗證。
替代方案有限公司觀點:台灣團隊該怎麼讀這份實測
把實測看完,我們的結論很簡單:Jev 本身的輸贏不是重點,能落地的是分流架構,也就是哪一段工作交給便宜又快的判斷模型、哪一段留給生成模型或真人。這跟模型準不準無關,跟你有沒有把問題分對有關。
分流對應的三種日常決策
分流不是抽象概念。一種是「從固定幾類挑一類」:客服來信進來,判斷屬於訂單、退換貨、帳務還是其他,再丟進對應佇列。一種是「表單與名單分類」:詢價單依產業別、需求類別貼標籤,讓業務知道先打給誰。還有一種是「流程裡的判斷節點」:流程圖上「要不要轉真人」的菱形,過去靠人點,現在可由模型給一個機率,超過門檻才升級。
這三種工作的共同點,是不必寫出任何一句話,只要一個帶把握程度的答案。獨立實測(ayautomate,2026-09-19,791 筆決策)已證明,只讓模型處理信心 0.80 以上的題目、其餘升級,準確度不打折,成本只要 26 到 28%。台灣團隊常見的困境不是模型不夠聰明,而是每次都用最貴的方式處理最簡單的問題。
中文沒有實測,這點我們要說清楚
所有獨立測試都是英文任務,中文與台灣場景(夾雜注音、簡稱、行話的客服信)沒有第三方數據。我們不拿英文成績替客戶背書。導入前一定先用客戶自己的資料跑小規模驗證:抓 200 到 500 筆真實案例、人工標好答案、量出準確率與信心分數的落差,再決定門檻值。若客戶手上已有幾百筆標籤,微調小模型或直接寫規則可能更便宜,這點我們也會老實講。
建議先挑一種量大、選項固定、而且能量測正確率的決策開始試,通常是客服來信分流,跑通了再往流程節點擴。分流設計對了,換哪一顆模型都行。
常見問題 FAQ
Q:Jev 官方說快 193 倍、便宜 444 倍,這個數字能信嗎?
這個數字是官方自家 workflow 的峰值自測,不是獨立量測。八天後的獨立盤點發現,速度其實落在「比跑在迷你電腦上的本地 Gemma 還慢一半」到「快 12.1 倍」之間;成本從貴 0.6 倍到便宜 478 倍都有,差別在於跟哪個模型比、在哪裡計時。791 筆決策的獨立實測結果是中位快 2.0 到 3.6 倍、便宜 4.7 到 7.5 倍,官方那個 193.6 倍並沒有出現。另外常被引用的 70 毫秒對 329 秒,是拿 Jev 去比一個完整思考鏈,兩邊任務根本不等對。方向是對的,幅度要打折看。
Q:那 Jev 到底該不該用?什麼情況才值得?
關鍵不是它多快,而是信心分數分流。獨立實測發現,只讓信心 0.80 以上的題目交給 Jev,其餘轉給前沿模型,準確度等於全程用前沿模型,成本只要 26 到 28%,延遲大約一半。所以值得用的情況是:題目選項固定、要重複做很多次、而且要求亞秒回應,例如客服來信分流、留言審核排序、判斷要不要轉真人。如果只是偶爾判斷一兩次,用便宜的生成模型或直接寫規則就好。另外要提醒,台灣目前沒有任何中文的獨立實測,導入前務必先用自家資料做小規模驗證。
Q:官方說它「不會幻覺」,這是真的嗎?
不能這樣講。正確說法是它不可能輸出選項表以外的值,但還是可能挑到一個合法卻錯誤的選項,型別安全不等於答案正確,官方文件也沒有這樣宣稱。它的機率也不是保證,連開源相容版本的說明都寫明機率沒有校準過。它還有官方自己列出的罩門:會照字面讀、數數不可靠、日期對它只是文字、狀態裡塞越多無關內容越不準,而且狀態不被當成敵意輸入,刻意爭取分類的文字可以推動答案。所以遇到低信心,還是要轉人工或升級給前沿模型。
📩 有任何問題或需要協助,歡迎聯絡我們:[email protected]
Related