Jev 怎麼用:choice、score、noul 三種問題型別,與五個台灣團隊可以直接抄的模式
目錄
共 13 個章節
Jev 不寫字只下判斷:choice、score、noul 三種問題型別怎麼挑
Jev 由 TypeSafe AI 在 2026 年 9 月 15 日發布。丟一段狀態給它,它不回句子,只回三樣東西:帶型別的答案、每個選項的機率、信心分數。信心分數(confidence)就是它對這個答案有多確定,程式直接讀欄位就能分流,不必解析它寫的中文。
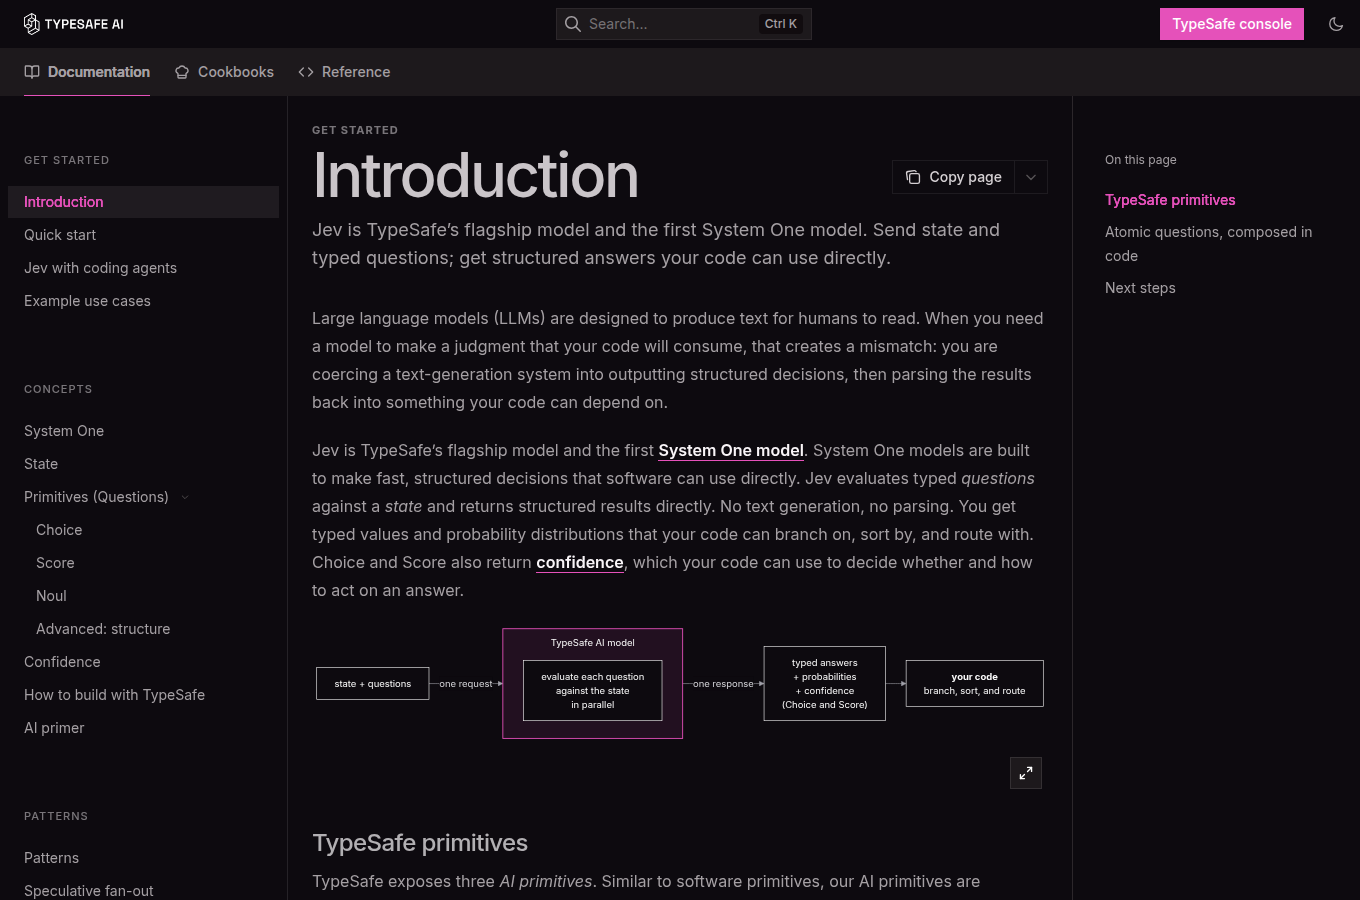
型別只有三種,挑錯型別,問出來的答案就不能用。
三種型別各自適合問什麼
- choice,從固定選項挑一個。適合選項本來就固定的問題,例如客服信要歸到訂單、退換貨、帳務還是其他。它回一個選項加上每個選項的機率,一眼看得出它有沒有猶豫。
- score,排先後或評等級。適合「有多急」「風險多高」這類有方向性的題目,例如留言審核依風險排序。
- noul,回一個 0 到 1 的機率。noul 是白努利(Bernoulli),也就是是非題的機率,例如「這張工單要不要轉真人」。官方執行長在 Hacker News 討論串親自回覆說明它其實就是白努利,並承認名字取得不好(2026)。
問錯型別:用 choice 問「這封信有多急」,只拿到類別、拿不到程度;用 score 問「該分給哪個部門」,拿到排序卻對應不到部門;用 noul 問三選一,有機率卻不知道落在哪一類。
Cloudflare Workers AI 的官方文件有一個真實回傳可以照著看(2026):狀態放一句「我的出款已經三天失敗」,同時問三題,回來的是 is_urgent 的 noul 為 0.95、department 的 choice 挑中 billing(信心 0.8,billing 0.87、technical 0.13、sales 0)、frustration 的 score 為 1.04(信心 0.94)。換成台灣場景,狀態改寫成「我上週訂的貨還沒到,而且我想退刷」,三題分別問要不要轉真人(noul)、該分到訂單、退換貨還是帳務(choice)、客戶情緒有多高(score),程式端只讀這幾個欄位就能分流。
兩個限制要放在心上。型別安全不等於答案正確:模型不會輸出選項表以外的值,但仍可能挑到合法卻錯誤的選項,「不會幻覺」是外界放大的說法。另一個是官方自己在 jaggedness 頁列出的(2026):狀態裡塞越多無關內容,判斷越不準;正確順序是先用程式檢索過濾,只送問題真的需要的欄位,再讓它下判斷。
五個可以直接抄的模式,與第一次呼叫要準備的東西
第一次呼叫要準備的三件事:金鑰、套件、網址三樣。官方候補制,多數團隊從 Vercel AI Gateway、OpenRouter 或 Cloudflare Workers AI 取得存取權。Python 的 typesafe-sdk 與 JavaScript 的 @typesafe-ai/sdk 會自動讀環境變數的金鑰,預設模型是 jev-latest。
呼叫位址只有 POST https://api.typesafe.ai/v1/systemone,curl 可直接打。回傳只有三樣要讀:帶型別的答案、每個選項的機率、信心分數。沒有文字理由,不必寫解析句子的程式,其餘欄位先忽略。
五個可以直接抄的模式
以下整理自 dev.to 實戰指南(2026)。
- 一次把相關問題全問完。官方 cookbook(2026)用一份 13 題法規簡報跑長篇維基文章,批次問比逐題問便宜 12.2 倍、快 10.0 倍,答案完全相同。台灣可用於合約同時問保密、期間、違約責任。
- 用信心分數決定誰要升級。高信心自己處理,低信心轉前沿模型或人工。第三方實測(ayautomate,2026-09-19)門檻設 0.80,準確度等於全程用前沿模型,成本只要 26 至 28%,延遲約一半。適合客服來信分流,前提是能量測正確率。
- 把模糊判斷拆成獨立維度。不問「候選人有多好」,而把技術深度、帶隊經驗、系統設計分開評分,權重留在程式加總,改權重等於改程式碼,可 A/B 測試。
- 串接式升級。便宜模型守第一關,決定哪些請求值得動用昂貴模型。官方自算:100 萬張工單約 6,480 美元可取代 30,400 美元,其中約 80 萬張半秒內答完(非獨立量測)。
- 先檢索再判斷。它只看到你交給它的狀態,不能自己查資料。先用程式篩過資料庫欄位,只送真正相關的三五欄。這步做錯,後面判斷再準也沒用。
五個模式的共同前提:量要夠大、選項要固定。一次只判斷一兩題,或還需要生成文字,寫規則或找便宜的生成模型往往更快。
官方自己列出的失敗清單,與「不會幻覺」的正確說法
多數模型發表只講強項,TypeSafe AI 反過來在文件站開了一頁 jaggedness(能力鋸齒:同一題行、隔壁題突然不行),標題寫明這是 jev-1.13 做不好的事,等於官方先幫你標好地雷。以下翻成白話並補上繞法。
官方承認的弱項,與實務上的繞法
- 照字面讀。否定詞(「不含」「除了」)與隱含條件都照字面處理,題目要把條件寫白。
- 不是計算機。數數不可靠,數量越大誤差越大;要數筆數、加總金額留在程式算。
- 日期只是文字。順序、間隔、是否落在區間都不可靠;抽日期用 choice 加「未提及」選項,排序比較回到程式端。
- 上下文會被稀釋。狀態塞越多無關內容,答案越不準;只送真正相關欄位。
- 狀態不是敵意輸入。狀態裡若有使用者能填的文字,對方可寫一段替自己爭取分類,這就是提示注入(prompt injection);過濾、隔離、不要直接相信。
- 矛盾指令會混亂。同一問題塞兩個判斷標準,答案會無法解釋。
- 不生成文字。要從自由文字取值,先用正規表達式或另一個生成模型撈候選,再讓 Jev 挑。
官方兩句元規則:別問模型程式能精確算的事;別在一題裡藏多個判斷。
「不會幻覺」這句話錯在哪裡
「不會幻覺」是官方行銷語言,文件本身沒這樣寫。正確說法:模型不會輸出選項表以外的值,但仍可能挑到合法卻錯誤的選項;型別安全管的是答案長什麼樣子,不是對不對。
機率也不能當保證。官方開源示範 SimpleJev 就註明,輸出的機率不是校準過的正確率(校準指機率數字與實際正確率是否對得上)。第三方 200 筆六模型比較中,Jev 準確率 72.5% 最低,校準誤差 0.161 最高(越低越好);官方 benchmark 也寫準確率 67.8%,最佳比較模型 74.1%。信心分數能當分流旋鈕,但要先用客戶資料量過、調門檻。
替代方案有限公司觀點:台灣團隊要抄的是分流架構,不是模型
該抄的不是模型,而是把判斷拆成「便宜模型先答、答不準往上送」的分流架構。技術早就公開:把 prompt 停在答案該開始的位置,只讀允許標籤的 token 分數,再取 softmax 換成機率。vLLM 用 logprob_token_ids、SGLang 用 /v1/score,Featherless 的 SimpleJev 甚至包成相容伺服器。2026-09-27 複核 GitHub 星數:Kev 7,279 顆、Nimble 1,851 顆。
分流線畫在哪裡:信心門檻與導入前的那份報表
2026-09-19 的 ayautomate 獨立實測(791 筆決策、3,955 次呼叫、1.53 美元):信心 0.80 以上交給便宜模型,其餘升級給前沿模型或人工,準確度等於全程用前沿模型,成本只要 26 到 28%,平均延遲約一半。門檻不能照抄 0.80,要用客戶自己的歷史資料從 0.5 掃到 0.95,逐格看成本、準確率、延遲再決定。導入前必須先做出來的報表至少包含:
- 每一類的樣本數與分布,確認選項是不是真的固定
- 不同門檻下的自動處理率、準確率、升級率
- 每一筆決策的成本與 P95 延遲,不是平均值
- 升級後由誰接手,人工與前沿模型的成本各是多少
- 用中文資料跑出來的同一組數字(沒有獨立中文實測,只能自己填)
我們的落地建議
台灣團隊最常犯的錯,是把 AI 當成「買一顆最強的模型解決所有事」。九成的企業判斷是分類、路由、要不要轉真人,不需要文采;問題不在模型智商,在架構有沒有分層。我們進客戶端第一件事不是選模型,是列出決策點,標出哪些選項固定、哪些量大、哪些本來就有標準答案,再建出上面那份報表。
三件事誠實講:中文沒有獨立實測,官方數字全來自英文任務,務必先用客戶資料做小規模驗證;客戶已有幾百筆標籤時,微調小模型或寫規則往往更便宜;狀態裡只要含使用者能控制的文字,就要當敵意輸入處理。開源版本幾個月內追上,我們賣的是分流線畫在哪裡、門檻調多少,以及出問題時看哪一張報表。
台灣團隊從哪一種決策開始試:六個場景對照
Jev 不生成文字,只回一個決定:choice 是選擇題,從固定選項挑一個;score 是評分,把東西排等級;noul 是是非題的機率,回 0 到 1 的數字,例如「這封客訴有多急」。挑型別先看流程裡有沒有「看一眼就要下決定」、每天重複很多次的動作。
六個場景,各自對應哪一種型別
| 場景 | 型別 | 白話說明 |
|---|---|---|
| 客服來信分流 | choice | 訂單、退換貨、帳務、其他挑一類 |
| 表單與名單分類 | choice | 產業別、需求類別、案件大小 |
| 留言與內容審核 | score | 依風險排等級,先處理最危險的 |
| 要不要轉真人 | noul | 回一個機率,超過門檻才升級 |
| 自動化流程判斷節點 | noul | 取代流程圖裡的人工判斷 |
| 出貨前檢查清單 | score 加 noul | 每項各問一次,程式加總 |
留言審核用 score 是為了排優先順序,出貨前檢查用 score 加 noul 是因為每項判斷方式各異;官方文件寫過,不要在一個問題裡藏好幾個判斷。
先做客服分流或轉真人,這兩件事本來就有人在判斷,調門檻時有現成答案可對照。ayautomate 在 2026 年 9 月 19 日公布的 791 筆決策測試顯示:只讓 Jev 回答信心分數 0.80 以上的題目、其餘轉給前沿模型,準確度等於全程用前沿模型,成本只要 26 到 28%。門檻是唯一要顧的旋鈕。
動手前要先確認的四件事
- 要有量測正確率的辦法,才知道哪些題目該自動、哪些該升級。
- 選項必須固定,會變來變去的任務先整理清單。
- 需要生成文字的工作不適用,寫回信、寫文案交給生成模型。
- 中文與台灣場景沒有獨立實測,第三方測試全是英文任務(資料截止 2026 年 9 月 27 日),導入前要用客戶自己的資料跑小規模驗證。
客戶若已有幾百筆標籤,微調小模型或寫規則常比接 API 便宜。先問這個決策累積了多少正確答案?答不出來就先做量測,不要先挑模型。
常見問題 FAQ
Q:Jev 跟平常在用的聊天 AI 差在哪?為什麼它都不回我一句話?
因為它本來就不生成文字,只回一個帶型別的答案加上機率。你問它「這封客服信該給誰」,它不會寫一段分析,而是直接回「billing、信心 0.87」這種程式可以直接讀的欄位。文章裡的實際回應是同時問三個問題,回傳緊急程度 0.95、部門挑中 billing、不滿分數 1.04,程式照這幾個值就能分流,完全不用解析句子。它有三種問法:choice 是從選項挑一個、score 是給有序的等級分數、noul 是回一個 0 到 1 的是非機率。要注意它的型別安全只保證不會生出名單以外的值,不保證挑對。
Q:choice、score、noul 這三種到底差在哪,我該用哪一種?
choice 適合選項固定的分類,例如客服信分成訂單、退換貨、帳務、其他。score 適合排序,例如留言審核依風險高低排,先處理最危險的。noul 回的是 0 到 1 的機率,用來決定「要不要轉真人」,超過你設的門檻才升級。三種的共同點是不用產出文字,只要一個判斷。實務上最常混著用,例如出貨前檢查清單每一項各自問一次,用程式加總。
Q:要裝什麼才能用?我的資料會不會跑出去?
安裝很簡單,Python 用 pip install typesafe-sdk、JS 用 npm install @typesafe-ai/sdk,兩邊都從環境變數讀金鑰,也可以走 OpenRouter、Vercel AI Gateway、Cloudflare Workers AI 這些管道。但要清楚一件事:狀態(一段文字或 JSON)會送到 api.typesafe.ai 的 /v1/systemone 端點,等於交給外部服務處理,性質跟用其他雲端 AI API 一樣。另外官方自己的文件提醒,狀態裡如果有使用者可以控制的文字,要當成敵意輸入看待,刻意替自己爭取分類的內容是有機會推動答案的。
📩 有任何問題或需要協助,歡迎聯絡我們:[email protected]
Related