實體.關係.屬性:打造「有用而非炫技」的知識圖譜設計原則

目錄
共 12 個章節
還記得第一次面對大型程式碼倉庫時的茫然嗎?數千個檔案、上萬個函式、錯綜複雜的依賴關係,如同迷宮般令人暈眩。但現在,情況正在改變。截至 2026 年 11 月 5 日,Understand-Anything 這款開源工具在 GitHub 上已獲得超過 9 萬顆星(GitHub API 實測 90,527 顆),它能自動將龐雜的程式碼轉換成可互動、可搜尋、甚至能直接提問的知識圖譜,而這一切的關鍵,就在於「實體、關係、屬性」的設計哲學。然而,真正值得探討的問題不是「如何建構圖譜」,而是「如何設計一張有用而非炫技的圖譜」,這也是本文的核心命題。
一、從迷宮到地圖:知識圖譜為何是「理解程式碼」的最佳解
傳統的靜態分析工具或編輯器搜尋功能,只能告訴你「這個函式被誰呼叫」,卻無法回答「這個模組為什麼需要依賴那個類別」。向量記憶(Vector Memory)雖然擅長語義相似度檢索,但在推理實體間的多跳關係時卻顯得無力,因為它做的是近似比對,抓得到主題相近的片段,卻說不出「A 是 B 的供應商,C 是 A 的客戶」這類確定的邏輯鏈。

知識圖譜則提供了根本性的不同:透過 實體、關係、觀察(Entity-Relation-Observation) 模式,查詢可以沿著已知的邊精確走訪,回傳的是一組確定的關係,而不是一堆相似度分數。這裡要提醒一個常見誤會:延遲數字沒有通用標準,圖譜查詢快或慢,取決於圖的大小、索引設計與後端儲存,不能拿單一 benchmark 套用到所有場景;能確定的只有性質差異,圖譜給你精確的關係集合,向量檢索給你近似的候選清單。
這套模式的規格可以追溯到 MCP 官方參考實作。其 memory server 的資料結構明確寫著:每個 Entity 包含唯一名稱、實體型別與觀察清單;Relation 是有向連接,以主動語態描述;Observation 則是離散事實,可獨立新增或移除。要注意的是,Understand-Anything 本身並不走 MCP Memory,它把圖譜存成專案目錄下的 .ua/knowledge-graph.json,再把同一份 JSON 交給儀表板呈現。兩者共用的是同一種思考方式,不是同一套程式。
正如 芝士貓的技術分析 所指出的,當企業需要理解實體之間的關係,例如「某個 Agent 擁有哪些工具」,向量記憶無法有效表達;圖譜則可以透過 MATCH (e:Agent {id: "a1"})-[:HAS_TOOL]->(t:Tool) 直接查詢,精準度與可審計性遠超向量搜尋。
「知識圖譜是用機器可理解的方式組織世界知識。」飛書文檔《知識圖譜的設計原則與 BEAR 原則》
然而,許多團隊在導入知識圖譜時,犯了「為圖譜而圖譜」的錯誤:把每個變數、每個字串都變成節點,結果圖譜比原始程式碼還難讀。Understand-Anything 之所以有效,正是因為它懂得取捨,只保留對理解程式碼真正關鍵的節點與連結。
二、實體(Entity):誰才是值得被記住的主角?
在程式碼知識圖譜中,最直覺的實體是「檔案」「函式」「類別」。但若盲目將所有符號都納入,圖譜會瞬間爆炸。根據 BEAR 原則,實體必須滿足 Business Essential 與 Actionable Relevance,也就是說,每個實體都要能回答一個具體的業務問題或工程問題。

在 Understand-Anything 的實際運作中,多智能體(multi-agent)流水線由 5 個專職代理組成,掃描整個專案後只選取以下實體類型:
- 檔案(File):作為命名空間邊界
- 函式(Function):可執行單元
- 類別(Class):物件導向封裝
- 介面(Interface / Abstract Class):抽象契約
- 模組(Module / Package):高階分組
這些實體都具備唯一識別符號(例如 com.example.service.UserService),並帶有型別與觀察清單。觀察(Observation)是一段自然語言描述或關鍵屬性,例如「此函式處理 HTTP POST 請求」「此類別實作了 Singleton 模式」。每個觀察可獨立審計,便於版本追蹤,後續修改程式碼時,只需更新對應的觀察,而不必重建整個圖譜。
值得一提的是它的分工方式:結構性事實(匯入、定義、呼叫點、繼承)由 Tree-sitter 靜態解析抽出,同一份程式碼每次跑出來都一樣;大型語言模型只負責產生人類看得懂的摘要、標籤、架構分層與導覽。這種確定性與語意分離的設計,正是圖譜不會每次重跑就變一個樣的原因。
相比之下,許多初學者會將「區域變數」「臨時物件」「列舉值」也視為實體,導致圖譜包含數十萬個低價值的節點。認清「真正的主角」是設計圖譜的第一堂課。
三、關係(Relation):連結的語意比節點本身更重要
如果說實體是名詞,關係就是動詞。MCP Memory 的規範強調,關係必須以「主動語態」儲存:UserService 依賴於 HttpClient,而非 UserService 和 HttpClient 有關聯。這種強制語意化設計,讓圖譜具備推理基礎。
在 Understand-Anything 的圖譜中,常見的關係包括:
DEFINES:檔案定義了某個類別CALLS:函式呼叫了另一個函式INHERITS:類別繼承自父類別IMPLEMENTS:類別實現了介面IMPORTS:檔案匯入了另一個模組
這些關係都是「有向」的,且支援多跳查詢。例如,你可以問「找出所有呼叫了 UserService.getUser() 的 Controller 類別」,圖譜會沿著 CALLS 邊反向遍歷,直接列出符合條件的節點。這正是圖譜勝過向量記憶的關鍵,向量記憶無法進行精確的關係連結,只能做近似匹配。
但關係設計也有陷阱:過多的關係類型會讓圖譜變得混亂。實務上一種場景的關係類型最好控制在 10 種以內,超過 20 種,維護成本會隨之上升。Understand-Anything 之所以能在關係數量有限的情況下仍好用,原因是它把結構邊交給語法解析器,型別自然收斂在匯入、定義、呼叫、繼承這幾類,不需要為了每個產業場景另創一套動詞,這是「少即是多」的具體實踐。
四、屬性(Observation):讓節點「說人話」的關鍵
在這套模式中,屬性並非傳統實體關係圖中的「欄位值」,而是以「觀察」形式存在的離散事實。每一條觀察都是一句完整陳述,例如:
{
  "entityId": "com.example.service.UserService",
  "observations": [
    "負責管理使用者註冊與身分驗證",
    "包含快取層防止重複查詢資料庫",
    "此服務無狀態,可水平擴展"
  ]
}
為什麼不直接把這些描述塞進實體的「屬性」欄位?因為屬性通常是固定結構,而觀察可獨立新增、移除、審計。當團隊重構程式碼時,只需修改對應的觀察,不需改動實體本身的結構定義。這種靈活性是向量記憶或傳統關聯式資料庫難以比擬的。
更重要的是,觀察可以由 AI 自動產生。Understand-Anything 的多智能體流水線會讀取原始碼結構、函式名稱、型別提示,再請大型語言模型生成摘要,並將這些摘要作為觀察附加到對應的實體上。但這裡有一個常見的錯誤:讓 AI 生成太多觀察,導致圖譜被無意義的形容詞淹沒。實務上,每個實體保留 3 到 5 條最關鍵的觀察即可,其餘細節應該留給程式碼本身,而非圖譜。
| 面向 | 知識圖譜(實體、關係、觀察) | 向量記憶 |
|---|---|---|
| 查詢特性 | 沿邊精確走訪,回傳確定關係 | 相似度排序,回傳近似候選 |
| 查詢延遲 | 依圖大小與後端而異,通常為毫秒級 | 需先計算相似度,資料量放大時同步上升 |
| 關聯推理 | 支援多跳、精準邏輯 | 僅相似度匹配 |
| 可觀測性 | 每條觀察可單獨審計 | 嵌入向量無法逐項審計 |
| 版本追蹤 | 觀察可獨立更新 | 需重新生成嵌入 |
| 模式設計成本 | 需要前期結構設計 | 無需結構化 |
| 適合場景 | 客戶支援自動化、程式碼理解 | 個人助手、快速檢索 |
五、打造「有用而非炫技」的圖譜:三條實戰鐵律
累積了上述原則後,我們可以歸納出具體的操作指南。以下是替代方案有限公司團隊在協助客戶導入知識圖譜時反覆驗證的鐵律:
鐵律一:以「問題」為導向,而非以「資料」為導向
先列出團隊最想解答的 5 個問題,例如:「此模組被哪些上游系統依賴?」「某個重大 bug 影響哪些函式?」。圖譜只包含能回答這些問題的實體與關係。多餘的節點一律刪除。
鐵律二:關係數量少於 10 種,觀察數量少於 5 條
圖譜不是百科全書。每個實體若超過 5 條觀察,表示你試圖把程式碼註解複製進圖譜,應該返回去改善程式碼可讀性,而非建立圖譜副本。
鐵律三:定期「修剪」而非「擴充」
程式碼會演化,圖譜也需同步。Understand-Anything 支援增量更新,只重新分析變更過的檔案;也可以啟用 /understand --auto-update,透過提交後掛鉤在每次提交時修補圖譜。定期修剪不再存在的節點,比不斷往圖裡加東西更有價值。
「圖譜是活的文件,不是死的靜態資產。」替代方案有限公司技術總監
六、實際案例:從程式碼倉庫到互動式知識地圖
假設你有一個中型 Spring Boot 專案,包含 200 個 Java 檔案。傳統方式要理解依賴關係,可能需要逐一閱讀 pom.xml 與 import 語句。現在,你只需要在終端機執行 /understand 指令(來自 Understand-Anything),掃描完成後再用 /understand-dashboard 開啟互動式圖譜:
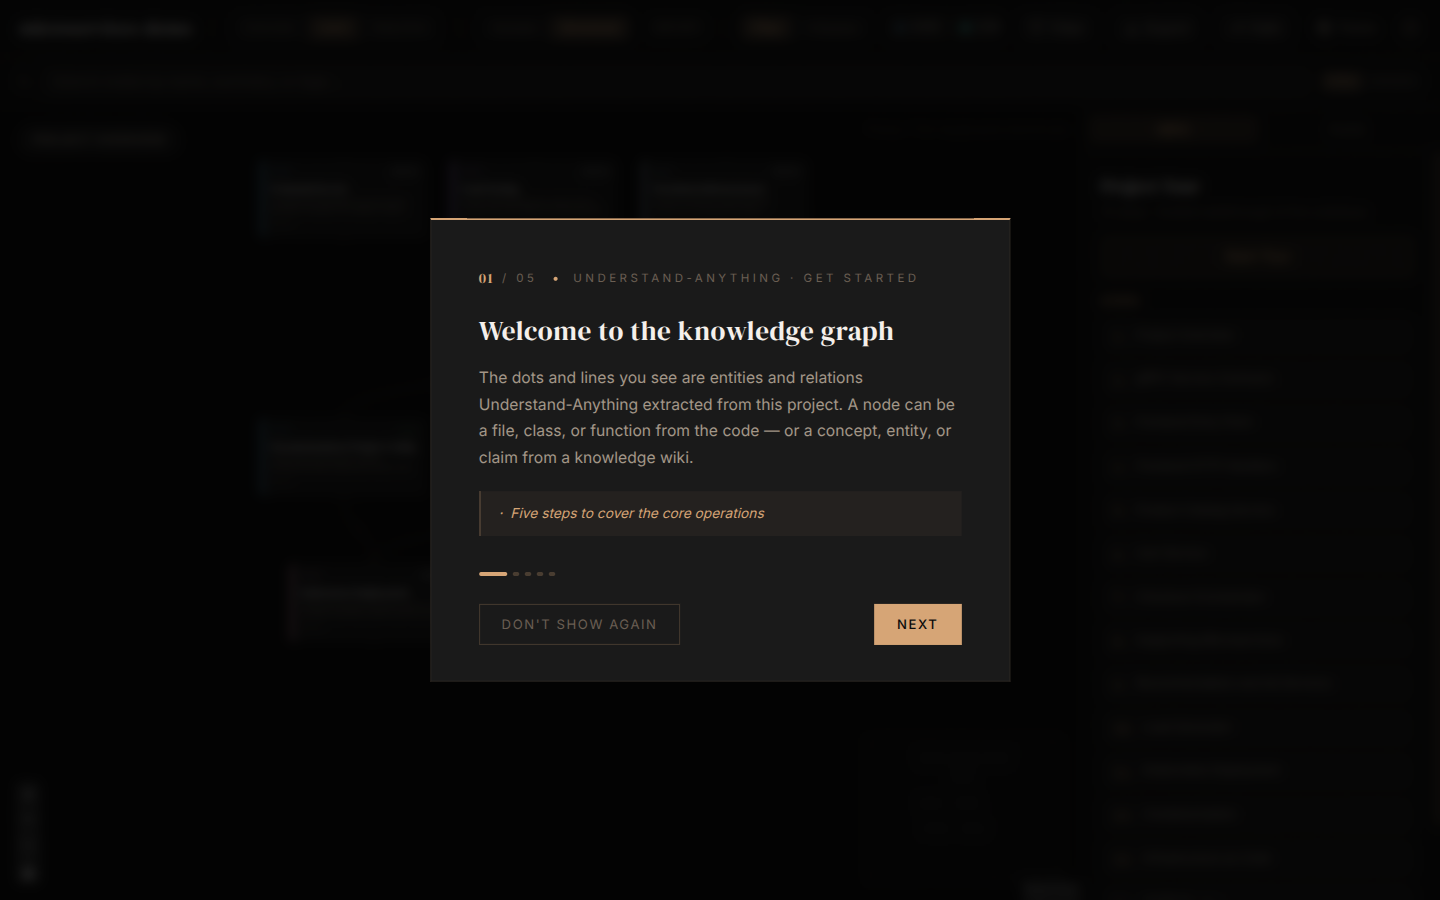
- 每個 Controller 節點帶有觀察:「處理 /api/users 路徑」「使用 JWT 驗證」
- Service 層與 Repository 層之間的
CALLS關係清晰可見 - 點擊某個節點,可以展開所有相關的函式呼叫鏈
若你使用的是 MCP Memory 協議,則可進一步整合到 Claude Code 或其他 AI 代理中。當代理需要理解「某個異常可能來自哪裡」時,它會透過圖譜查詢而非向量檢索,直接定位到最可能的根源,因為圖譜保留了實體間的因果關係。
常見問答:知識圖譜設計常見迷思
Q1:知識圖譜和傳統實體關係圖有什麼不同?
A:實體關係圖專注於資料庫表格與欄位,強調正規化與關聯;知識圖譜則強調語義與推理,支援多跳查詢與動態觀察。知識圖譜的節點是「概念」或「物件」,而非「資料表列」。
Q2:何時該選用向量記憶而非圖譜?
A:當場景只需要「找到相似內容」(例如個人助手搜尋聊天記錄)時,向量記憶的快速部署與低模式成本更有優勢。但若需要精確的關係推演(例如「找出 A 的所有間接供應商」),圖譜是唯一解。
Q3:Understand-Anything 支援哪些程式語言?
A:根據官方說明,它可處理多數主流語言的專案(Java、Python、JavaScript、TypeScript、Go、Rust 等),掃描階段會自動偵測語言與框架,並支援超過 26 種檔案類型。
Q4:如何避免圖譜過於龐大?
A:嚴格遵守「問題驅動」原則。每次新增實體前問自己:「這個節點能幫助解答哪個具體問題?」。若答不出來,就不該加入。
Q5:圖譜可以結合大語言模型使用嗎?
A:可以。圖譜提供精確的結構化知識,而大型語言模型負責理解自然語言查詢並轉換成圖查詢語句(例如 Cypher)。兩者互補,能建構出強大的「可推理 AI 系統」。
替代方案有限公司的觀點段落
在替代方案有限公司的顧問經驗中,我們看過太多團隊花費數月時間建構華麗的知識圖譜,最後卻無人使用。原因無他,圖譜設計得太「聰明」,卻不夠「實用」。我們建議所有團隊回歸基本:只保留對理解程式碼真正關鍵的節點與連結,讓圖譜成為「可互動的架構文件」,而非「另一個需要維護的技術債」。如果您正在評估導入知識圖譜,不妨先從一個小模組開始,確認它真的回答得了你每天在問的問題,再逐步擴展。
結論:讓圖譜服務開發者,而非反過來
實體、關係、屬性,這三個看似簡單的元件,在 MCP Memory 與 Understand-Anything 的實踐中,展現出驚人的威力。從精確的關係查詢到可審計的觀察,知識圖譜正逐步取代傳統的文件與 Wiki,成為新一代程式碼理解的基礎設施。
但最重要的提醒是:圖譜只是工具,不是目的。真正有價值的不是節點數量與連線密度,而是圖譜能否幫助你「更快、更準」地回答問題。下次當你興致勃勃地想加入一個新實體時,請停下來問自己:「這個節點能讓團隊少開一次會議嗎?」如果答案是「是」,那就勇敢地畫上去;如果猶豫,就留給未來的自己決定。
現在,就從你的專案開始吧。執行 /understand,體驗知識圖譜的真正力量。若有任何疑問,歡迎參考我們之前的文章:解構多智能體流水線:Understand-Anything 如何自動繪製程式碼知識地圖,深入理解背後的工程原理。
Related